
Nftables to programowalny filtr pakietów systemu Linux, w którym mechanizm dopasowywania zaimplementowano w postaci podprogramów maszyny wirtualnej kompilowanych do pseudokodu w trakcie korzystania z narzędzia sterującego regułami. Jest to wysokowydajna i bardzo elastyczna aparatura zintegrowana z podsystemem Netfilter, służąca nie tylko do budowania zapór, lecz również do translacji adresów, klasyfikowania, zliczania i kierowania ruchu. Tworzenie reguł przypomina trochę pisanie programów bazujących na zdarzeniach.
Pierwsza wersja tego artykułu powstała w roku 2015. Tekst zachowuje historyczne tło, ale opis samego nftables, przykłady i diagramy zostały zaktualizowane w roku 2026 zgodnie ze współczesnym narzędziem nft i interfejsami kernela Linux.
Wprowadzenie
Zapora sieciowa, zwana też ścianą przeciwogniową (ang. firewall), to aktywny element sieciowy, którego zadaniem jest filtrowanie ruchu, czyli zarządzanie wzajemną widocznością stacji sieciowych, co pozwala realizować ochronę infrastruktury lub systemu przed intruzami. Istnieją sprzętowe firewalle, ale mamy też do czynienia z zaporami software’owymi, wbudowanymi w systemy operacyjne. Te ostatnie nie muszą być wcale mniej wydajne niż sprzętowe, a często są znacznie bardziej elastyczne w obsłudze, mają też więcej nowatorskich funkcji. Problem z nimi polega na awaryjności urządzeń, które składają się z wielu komponentów (komputery), a także na tym, że system może być obciążony przez inne realizowane zadania.
Zapora może działać w różnych warstwach modelu ISO/OSI. Spotkamy więc firewalle kontrolujące ruch na poziomie ramek sieciowych (w warstwie łącza danych), na poziomie IP (w warstwie sieciowej), a także na poziomie obsługi protokołów TCP i UDP (w warstwie transportowej). Bardziej zaawansowane zapory, tzw. firewalle aplikacyjne, dokonują inspekcji zawartości pakietów i zajmują się ochroną na poziomie warstwy aplikacyjnej (np. protokołu HTTP czy SMTP). Co do zasady wszystkie firewalle nie różnią się jednak – ich zadaniem jest sprawowanie kontroli nad tym kto z kim i w jaki sposób może się komunikować.
W dużym skrócie i uproszczeniu: warstwa łącza odpowiada za komunikację jednej stacji sieciowej z drugą w obrębie tego samego nośnika (np. segmentu ethernetowego); warstwa sieciowa pozwala wymieniać informacje między systemami operacyjnymi identyfikowanymi w sposób niezależny od medium (np. adresami IP); zaś warstwa transportowa pozwala wskazywać konkretne uruchomione programy działające w komunikujących systemach (np. z użyciem numeru portu).
Warstwa łącza przypomina samochód dostawczy, warstwa sieciowa naczepę zawierającą towary wysyłane pod konkretny adres, a warstwa transportowa paczki oznaczone numerami mieszkań, które mają trafić do odpowiednich lokatorów. Zawartość paczki to już warstwa konkretnego zastosowania, czyli aplikacyjna.
Proces umieszczania zawartości należącej do warstw wyższych w kontenerach warstw niższych nosi nazwę kapsułkowania (ang. encapsulation), a proces odwrotny odkapsułkowania (ang. deencapsulation).
W powyższej analogii z samochodem zapora przypomina osobę, która go zatrzymuje i dokonuje inspekcji. W zależności od kompetencji i uprawnień może to być tylko sprawdzenie dokąd kierowca się udaje (warstwa łącza), zbadanie trasy oraz kondycji naczepy (warstwa sieciowa) czy konkretnych paczek (warstwa transportowa), albo nawet rewidowanie zawartości przesyłek (warstwa aplikacyjna).
Historia
Przypomnijmy sobie jak wyglądało filtrowanie pakietów w kernelu Linux na przestrzeni lat.
Ipfwadm
Linux już przed linią 2.0 był wyposażony w prosty mechanizm filtrowania pakietów sieciowych. W jądrze 2.0 regułami tego mechanizmu sterowało narzędzie ipfwadm (IP Firewall Administration). Odpowiednia obsługa musiała być włączona podczas konfigurowania kernela, ale sam filtr był jego częścią, a nie zewnętrzną łatą.
Dzięki ipfwadm i poleceniu o tej samej nazwie administrator mógł ustanawiać reguły w jednym z kilku z góry zdefiniowanych zestawów:
- input (pakiety przychodzące),
- output (pakiety wychodzące z systemu),
- forwarding (pakiety przekazywane między interfejsami sieciowymi),
- accounting (wszystkie pakiety poddawane zliczaniu).
Zapora działała w ten sposób, że każdy pakiet sieciowy był dopasowywany do kolejnych reguł odpowiedniego zestawu (w zależności od tego czy emitowany lokalnie, przekazywany, czy może kierowany do systemu). Filtr rozpoznawał protokoły IP, TCP, UDP oraz ICMP. Umożliwiał też zastosowanie jednej ze strategii ich obsługi:
- przyjmowanie pakietu (accept);
- odrzucanie pakietu (reject);
- ignorowanie pakietu (deny).
Ipfwadm pozwalał również na wprowadzenie prostej translacji adresów źródłowych w trybie jeden do jednego lub wiele do jednego (tzw. maskarada adresu lub podsieci).
Spójrzmy na przykład użycia polecenia, które do zestawu reguł wejściowych dodaje
blokowanie pakietów TCP kierowanych do portu o numerze 80 ze stacji o adresie IP
192.168.0.2:
ipfwadm -I -a deny -P tcp -S 192.168.0.2 -D 0.0.0.0/0 80
ipfwadm -I -a deny -P tcp -S 192.168.0.2 -D 0.0.0.0/0 80
Opcja -a z wartością deny określa tzw. cel reguły (ang. rule target),
natomiast specyfikacje protokołu, adresów i numeru portu to kryteria
dopasowywania (ang. match criteria). Z tymi lub podobnymi terminami możemy się
spotkać we wszystkich firewallach.
Kryteriami reguły tej zapory mogły być adresy, numery portów, protokoły, nazwy interfejsów sieciowych i niektóre flagi nagłówków pakietów. Jeżeli administrator chciał uruchomić przekazywanie między portami (ang. port forwarding), musiał korzystać z narzędzia ipautofw działającego w przestrzeni użytkownika lub narzędzia ipportfw korzystającego z mechanizmów kernela.
Ipchains
Wraz z nadejściem kerneli z linii 2.2 pojawił się usprawniony mechanizm kontroli ruchu sieciowego nazwany ipchains (Linux IP Firewalling Chains). Bazował on na kodzie ipfwadm, w którym dokonano usprawnień dotyczących maksymalnych wartości liczników pakietowych czy filtrowania uszkodzonych i szkodliwych nagłówków. Wprowadzono również obsługę większej liczby protokołów sieciowych oraz możliwość odwróconego dopasowywania reguł. Podział na zestawy pozostał taki sam, jednak nazwano je łańcuchami (ang. chains).
Nowością było wprowadzenie drzewiastej struktury reguł. W ipfwadm mieliśmy do czynienia z kilkoma zestawami, do których mogliśmy dodawać reguły filtrujące, natomiast w ipchains pojawiła się możliwość tworzenia własnych. Stąd właśnie zmiana nazwy. Dzięki łańcuchom powtarzalne zestawy filtrów można było umieszczać w osobnych przestrzeniach (łańcuchach użytkownika), a następnie do łańcuchów wbudowanych (tj. input, output czy forward) dodawać reguły, które część ruchu przekażą do jednego z tych pierwszych w celu dalszego przetwarzania.
W związku z możliwością dodawania nowych łańcuchów reguł wprowadzono też opcję korzystania z ich identyfikatorów jako celów – zamiast accept czy reject, celem reguły mogło być przekazanie pakietu do łańcucha utworzonego przez administratora. Dodano też cel o nazwie return, którego użycie sprawia, że następuje powrót do łańcucha nadrzędnego (z którego przekazano kontrolę nad pasującym do danej reguły pakietem). Aby obsługiwać maskaradę IP (ang. IP masquerade) i przezroczystego pośrednika, dodano też cele masq i redirect.
Warto wspomnieć, że w samym narzędziu ipchains dodano również opcję replace, dzięki której można było zastępować reguły bez konieczności ich wcześniejszego kasowania i ponownego dodawania.
Netfilter i iptables
W kernelach z serii 2.4 mieliśmy do czynienia z pewnego rodzaju przełomem w kwestii obsługi sieci. Pojawił się wbudowany w jądro podsystem Netfilter – pierwszy mocno zintegrowany z innymi komponentami sieciowymi klasyfikator z ujednoliconym interfejsem służącym do sterowania mechanizmami kontroli ruchu. Dzięki bliskiej integracji z pozostałymi komponentami sterowania przepływem możliwe stało się stosowanie znacznie bardziej elastycznych i precyzyjnych strategii kontroli.
Gdy Netfilter był gotowy, pojawiło się też – użytkowane do dziś – narzędzie iptables (IP Tables) służące do sterowania ustawieniami filtra pakietowego i mechanizmów translacji adresów sieciowych (ang. Network Address Translation, skr. NAT). Do poprawnej pracy zapory sterowanej tym oprogramowaniem wymagane są odpowiednie moduły jądra (np. x_tables i ip_tables). Żeby sterować filtrami, których obsługę dodano w kernelu później, używa się dodatkowych programów: ip6tables (obsługa IPv6), arptables (filtrowanie ruchu ARP) czy ebtables (filtrowanie na poziomie mostków sieciowych).
Netfilter wprowadza następujące ulepszenia w stosunku do poprzedniego kodu filtrującego:
-
inspekcja stanu (ang. stateful inspection)
na poziomie protokołów (IPv4 i IPv6) oraz aplikacji (IPv4); -
port forwarding nie wymagający usług działających w przestrzeni użytkownika;
-
pełna obsługa NAT (1 do 1 oraz 1 do wielu);
-
integracja z podsystemem jakości usługi (ang. Quality of Service, skr. QoS);
-
integracja z IP sets (bazy adresów IP w wydajnych strukturach).
W samym podsystemie iptables poza wbudowanymi łańcuchami reguł (input, output i forward) pojawiły się dodatkowo prerouting oraz postrouting. Pierwszy łańcuch jest sprawdzany zanim zapadnie decyzja o wyborze trasy pakietu (lub uznania go za przeznaczony dla lokalnego procesu), a drugi wtedy, gdy decyzja taka już zapadła i pakiet ma opuścić system. Jest to możliwe dzięki mechanizmowi tzw. podpięć (ang. hooks). Pozwalają one, aby inne moduły jądra (np. x_tables i ip_tables, czy właśnie nf_tables) rejestrowały w Netfilterze własne funkcje, do których na różnych etapach przetwarzania pakietów i ramek będą kierowane datagramy.
Tabele iptables
W iptables łańcuchy reguł nie są najwyższym poziomem abstrakcji, lecz przynależą do tzw. tabel (ang. tables). Są one zbiorami zawierającymi łańcuchy, które sterują różnymi funkcjami firewalla – np. osobna tabela odpowiada za translację adresów (NAT), a osobna za filtrowanie.
Tabele nie pochodzą z Netfiltera, lecz są sposobem organizowania reguł w iptables, który odzwierciedla odpowiednie etapy „podróży” pakietu przez stos obsługi sieci. Każda tabela zawiera pewne wbudowane łańcuchy, do których trafiają pakiety pochodzące z zarejestrowanych wcześniej podpięć. Nie należy wyobrażać sobie tabel jako pojedynczych punktów tranzytowych – wiele z nich jest „odwiedzanych” przez dany pakiet częściej niż raz, chociaż w kolejnych momentach trafi on do różnych wbudowanych w daną tabelę łańcuchów.
Ścieżki przepływu
Chociaż tabele i zawarte w nich łańcuchy reguł nie są ściśle związane z podsystemem Netfilter, pozwalają łatwiej zrozumieć, jak dokładnie wygląda klasyfikowanie pakietów. Taki przykład schematu ilustrującego drogę pakietu przez kolejne elementy mechanizmu obsługi sieci można znaleźć w zasobach Wikimedia Commons lub klikając obrazek umieszczony poniżej.
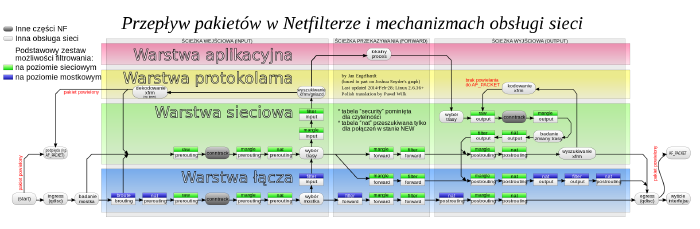
Przypomnijmy sobie funkcje poszczególnych tabel iptables i przypisane do nich wbudowane łańcuchy, do których z użyciem podpięć Netfiltera kierowane są pakiety sieciowe:
- tabela raw:
- łańcuchy: prerouting, output;
- przeznaczenie: bardzo wczesne przetwarzanie, przede wszystkim wyłączanie śledzenia wybranych pakietów oraz ustawianie parametrów mechanizmu conntrack;
- tabela filter:
- łańcuchy: input, forward, output;
- przeznaczenie: filtrowanie ruchu sieciowego;
- tabela nat:
- łańcuchy: prerouting, output, postrouting;
- przeznaczenie: translacja adresów (NAT);
- tabela mangle:
- łańcuchy: prerouting, input, forward, output, postrouting;
- przeznaczenie: wprowadzanie zmian w pakietach;
- tabela security:
- łańcuchy: input, forward, output;
- przeznaczenie: współpraca z mechanizmami obowiązkowej kontroli dostępu (ang. Mandatory Access Control, skr. MAC), takimi jak np. SELinux.
Śledzenie i inspekcja stanu
Ponieważ Netfilter wyposażony jest w moduł śledzenia połączeń (ang. connection tracking), każdy badany pakiet może zostać oznaczony jednym z abstrakcyjnych stanów wynikających z obserwacji przepływu:
- new – widziano poprawny początek komunikacji, dotychczas tylko w jednym kierunku;
- established – widziano poprawny ruch w obu kierunkach;
- related – połączenie jest oczekiwane na podstawie innego, wcześniej śledzonego połączenia;
- invalid – pakiet nie pasuje do oczekiwanego zachowania śledzonego przepływu;
- untracked – pakiet został jawnie wyłączony ze śledzenia.
Dzięki śledzeniu połączeń i znakowaniu pakietów przechodzących przez zestawy reguł, administrator może korzystać z kryteriów decyzyjnych bazujących na stanach.
Oznaczanie pakietów stanami odbywa się zaraz po etapie przetwarzania w łańcuchu prerouting przypisanego do tabeli raw. Jest to też miejsce, gdzie z użyciem specjalnych reguł możemy wpływać na to, jakie moduły śledzące zostaną wykorzystane w konkretnych przypadkach. W praktyce śledzenie połączeń polega nie tylko na uzyskiwaniu informacji z nagłówków (np. pakietów TCP), ale również z przenoszonych w pakietach danych aplikacyjnych.
Przykładem, gdy nie wystarcza samo śledzenie nagłówków warstwy transportowej, może być
protokół FTP. W jego sesjach korzysta się z dwóch połączeń TCP: jednego do wydawania
poleceń, a drugiego do przesyłania plików. Nawiązanie połączenia z portem o numerze
21 i przesłanie żądania pobrania pliku sprawia, że serwer instruuje klienta do
jakiego portu musi wykonać połączenie, aby pobrać dane. Aby śledzić tak nawiązywane,
nowe połączenie, zaś jego pakietom nadać stan related, zapora sieciowa musi
w jakiś sposób poznać treść komunikatu warstwy aplikacyjnej (dialogu klienta
z serwerem) i na podstawie wykrytego łańcucha tekstowego (zawierającego numer portu)
utworzyć wpis w tabeli śledzenia połączeń. Umożliwia to odpowiedni moduł
pomocniczy. W nftables nie należy zakładać, że zostanie on przypisany
automatycznie na podstawie numeru portu. Administrator definiuje obiekt ct helper
i przypisuje go jawnie instrukcją ct helper set. Reguły dopuszczające ruch
related powinny przy tym ograniczać adres docelowy, aby pomocnik nie otworzył
niezamierzonej drogi przekazywania portów.
Cele
W czyniącym użytek z Netfiltera narzędziu iptables możemy mieć do czynienia z celami reguł, których liczba zwiększyła się w stosunku do poprzedników. Podstawowy zestaw wygląda tak:
- accept – przyjęcie pakietu;
- reject – odrzucenie pakietu z poinformowaniem drugiej strony;
- drop – zablokowanie pakietu (w poprzednich: deny);
- queue – przekazanie pakietu do obsługi przez proces użytkownika;
- return – powrót do nadrzędnego łańcucha.
Poza wypisanymi powyżej istnieją też cele specyficzne dla konkretnych tabel i łańcuchów (np. log, mark i mirror), jednak nie będziemy ich teraz omawiać.
Nftables
Nftables (Netfilter Tables) to mechanizm zarządzania klasyfikacją i przetwarzaniem pakietów w kernelu Linux, będący następcą iptables. Projekt został zapoczątkowany w roku 2008 przez Patricka McHardy’ego. Jak sama nazwa wskazuje, nftables również korzysta z podsystemu Netfilter i również mamy do czynienia z tabelami. Kod zapory został stworzony od podstaw i nie bazuje na iptables, chociaż zachowano sposób organizowania reguł w łańcuchy i tabele.
Składniki
Nftables składa się z kilku komponentów:
- podprogramów obsługi w jądrze;
- biblioteki libmnl (do obsługi komunikacji przez gniazda Netlink);
- biblioteki libnftnl (do obsługi API nftables za pośrednictwem libmnl);
- biblioteki libnftables, która udostępnia wysokopoziomowy interfejs, w tym reprezentację JSON;
- oprogramowania użytkowego (polecenie nft), które służy do zarządzania regułami.
Pierwsze wydanie kernela zawierające nftables ukazało się w roku 2014. Obecnie potrzebne biblioteki i narzędzie nft są dostępne w repozytoriach głównych dystrybucji GNU/Linuksa. Samodzielna kompilacja jest potrzebna przede wszystkim podczas rozwijania oprogramowania lub korzystania z funkcji nowszych niż te, które oferuje używana dystrybucja.
Podobieństwa i różnice
Czym w skrócie różni się nftables od iptables? Uproszczono kernelowy interfejs binarny aplikacji (ang. Application Binary Interface, skr. ABI), „odchudzono” kod (w iptables niektóre fragmenty były po prostu powielane), ulepszono obsługę raportowania błędów, a także wprowadzono całkiem nowy sposób wyrażania i przetwarzania reguł.
Zamiast narzędzi iptables, ebtables, arptables i ip6tables mamy jedno polecenie, które steruje filtrami, a kod w kernelu jest niezależny od protokołów i warstw.
Podobnie jak w iptables wciąż mamy do czynienia z łańcuchami reguł, które są umieszczane w tabelach, jednak nie istnieją łańcuchy wbudowane, na stałe podpięte do Netfiltera. Zamiast tego administrator zapory bazującej na nftables może tworzyć dowolne tabele, a następnie umieszczać w nich dowolne łańcuchy. Te ostatnie mogą być (ale nie muszą) kojarzone z wybranymi punktami ścieżek przepływu.
Generyczne kryteria
Nftables wprowadza do kernela maszynę wirtualną, która odpowiedzialna jest za uruchamianie pseudokodu pochodzącego z przestrzeni użytkownika. Pseudokod ten jest wcześniej wysyłany przez gniazdo typu Netlink z narzędzia nft po dokonaniu interpretacji i kompilacji wprowadzonych reguł. Dzięki temu dodawanie nowych funkcji i strategii filtrowania ruchu jest ułatwione – dodatkowa warstwa abstrakcji pozwala wyeliminować sztywne struktury przechowujące reguły.
Zastosowanie maszyny wirtualnej ogranicza konieczność tworzenia osobnych struktur reguł dla każdej kombinacji protokołu i kryterium. Nie eliminuje jednak rozszerzeń kernelowych: odczyt naprawdę nowych danych lub wykonanie nowej operacji nadal może wymagać dodania odpowiedniego wyrażenia czy modułu. Kod w kernelu, który jest odpowiedzialny za badanie kryteriów dopasowywania pakietów, został uproszczony w stosunku do poprzednich mechanizmów (takich jak iptables czy ipchains). Potrafi on odczytywać zawartość (ładunek) pakietu, informacje nagłówkowe i skojarzone z pakietem metadane (np. interfejs wejściowy i wyjściowy bądź stan w kontekście śledzenia połączeń), a na bazie tych informacji i zestawu operatorów (arytmetycznych, bitowych i porównywania) mogą być konstruowane bardziej wyszukane filtry.
Maszyna wirtualna pozwala składać potrzebne operacje bez narzutu wynikającego z przechodzenia przez nieużywane klasy rozszerzeń. Nie znika jednak koszt liniowego przeglądania długiego łańcucha. Właśnie dlatego ważną częścią nftables są zbiory, mapy i złączenia, które pozwalają zastąpić wiele podobnych reguł jednym wyszukaniem.
Użycie maszyny wirtualnej oszczędza czas programistów i daje elastyczność administratorowi. Inspiracją dla takiego podejścia był znany z systemów typu BSD filtr Berkeley Packet Filter (skr. BPF).
W pierwszych latach rozwoju projektu pojawiał się zarzut, że autorzy nftables mogli wykorzystać istniejący silnik BPF. Była to dyskusja dotycząca ówczesnego, klasycznego BPF i nie należy jej bezpośrednio odnosić do współczesnego eBPF oraz XDP. Nftables jest stanowym silnikiem polityki Netfiltera, zintegrowanym m.in. ze śledzeniem połączeń i NAT; eBPF jest ogólniejszą aparaturą uruchamiania zweryfikowanych programów w różnych punktach kernela. Mechanizmy te mogą się uzupełniać, a nie tylko ze sobą konkurować.
Przykład obsługi
Spójrzmy na uproszczony diagram ilustrujący najważniejsze ścieżki przepływu ruchu sieciowego:
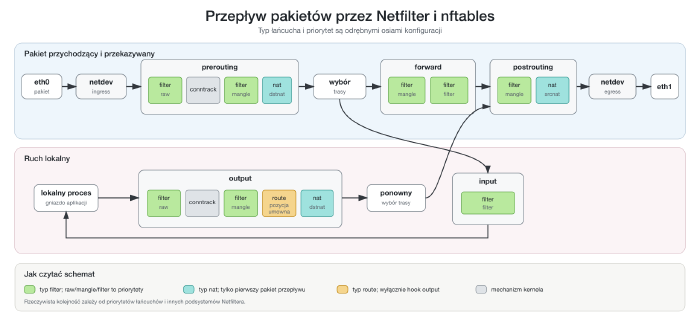
Uproszczony i zaktualizowany diagram ścieżek przepływu w podsystemie Netfilter z nazwami podpięć i typów łańcuchów
Nazwy prerouting, input, forward, output i postrouting oznaczają podpięcia Netfiltera. Kolorowe pola pokazują natomiast typ łańcucha i jego umowny priorytet. Są to dwie odrębne osie konfiguracji: raw, mangle, filter, dstnat i srcnat nie są typami łańcuchów, lecz symbolicznymi nazwami priorytetów. Typ route ma sens wyłącznie przy podpięciu output, a łańcuch typu nat ogląda tylko pierwszy pakiet przepływu. Położenie pola route na schemacie nie nadaje mu stałego priorytetu – wartość tę określa administrator.
W nftables tabele nie są powiązane z etapami przetwarzania. Grupują łańcuchy i inne obiekty odnoszące się do wybranej rodziny protokołów. Łańcuchy bazowe oraz ich podpięcia tworzy się samodzielnie. Diagram nie oznacza przy tym, że każdy pokazany łańcuch istnieje w każdej konfiguracji; przedstawia miejsca, w których administrator może go umieścić, oraz typową kolejność wynikającą z priorytetów.
Poniższy schemat ujmuje tę samą ścieżkę z innej perspektywy. Pokazuje, które podpięcia odwiedzane są przez trzy podstawowe klasy ruchu i jakie typowe sloty priorytetów mogą być obsadzone wewnątrz każdego podpięcia:
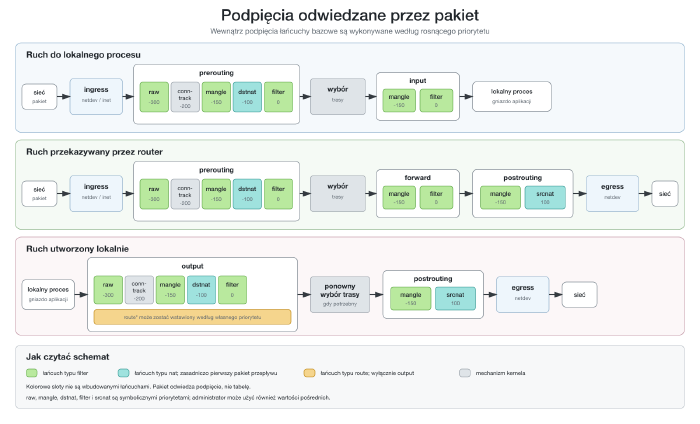
Ścieżki można zapisać również bez rysunku:
- ruch do lokalnego procesu: ingress → prerouting → wybór trasy → input;
- ruch przekazywany: ingress → prerouting → wybór trasy → forward → postrouting → egress;
- ruch utworzony lokalnie: output → ewentualny ponowny wybór trasy → postrouting → egress.
Pakiet odwiedza zatem podpięcie, a nie tabelę. Tabela jest przestrzenią nazw dla obiektów rulesetu. W jednym podpięciu może działać wiele łańcuchów bazowych, których kolejność wynika z priorytetów. Pokazane wartości są standardowymi punktami odniesienia, lecz administrator może użyć również wartości pośrednich.
Spróbujmy, patrząc na schemat, prześledzić los hipotetycznego pakietu
sieciowego. Załóżmy, że dla niego nasz system będzie tylko miejscem tranzytowym,
tzn. routerem, zaś celem serwer WWW w podsieci usługowej. Załóżmy też, że serwery
w tej podsieci posługują się adresami IP z prywatnych pul, a nasz firewall musi
dokonywać translacji adresów docelowych. Interfejsem wejściowym (publicznym) będzie
eth0, a wyjściowym (połączonym z usługami) eth1.
Przykład ten jest w miarę uniwersalny i ułatwia zrozumienie w jaki sposób działają zapory sieciowe korzystające z podsystemu Netfilter:
-
Na interfejsie eth0 pojawia się ramka zaadresowana do karty sieciowej, a w niej znajduje się pakiet IP przenoszący dane TCP z żądaniem nawiązania połączenia (ustawiona flaga SYN).
-
Podprogram obsługi warstwy łącza danych rezerwuje odpowiednią strukturę na obsługę ramki.
-
Ramka (reprezentująca ją struktura) jest przekazywana do podsystemu QoS (kolejka ingress klasy qdisc). Jeżeli skonfigurowano łańcuch netdev ingress albo inet ingress, pakiet jest następnie przetwarzany w tym podpięciu, jeszcze przed obsługą protokołu warstwy sieciowej.
-
System decyduje czy przekazać ramkę do interfejsu mostkującego (ang. bridge) celem przesłania do innego segmentu. Ponieważ nie mamy do czynienia z taką sytuacją, kończy się obsługa ramki i jej zawartość zostaje odkapsułkowana. Wewnątrz znajduje się pakiet IP, który zostaje przekazany do podprogramu obsługi warstwy sieciowej.
-
Podprogram obsługi warstwy sieciowej rezerwuje odpowiednią strukturę i umieszcza w niej pakiet IP.
-
Dane pakietu dopasowywane są do reguł łańcucha typu filter, obsługiwanych przez podpięcie prerouting o niskiej wartości priorytetu (odpowiednik tabeli raw w iptables). W tym miejscu administrator może ustanowić regułę, która wyłączy inspekcję stanu dla pakietów o pewnych właściwościach albo przypisze je do wybranej strefy śledzenia.
-
Jeżeli pakiet nie został odrzucony lub zignorowany, trafia do podsystemu śledzenia połączeń (conntrack). Tam, na podstawie analizy jego nagłówka i danych, a także porównania z systemową tabelą połączeń, zostaje odpowiednio oznaczony, a w systemowej tabeli pojawia się lub zostaje zaktualizowany wpis o połączeniu. Wykorzystywane są tu niektóre znaczniki sterujące śledzeniem, jeżeli były wcześniej ustawione.
-
Pakiet może trafić do łańcucha typu filter podpiętego w punkcie prerouting z priorytetem odpowiadającym etapowi mangle, gdzie może zostać oznaczony lub zmieniony, jeżeli określono to regułami.
-
Pakiet trafia do łańcucha typu nat przez podpięcie prerouting, gdzie może być zmieniony jego adres docelowy. Znajdzie się tu reguła translacji sieciowych adresów docelowych (ang. Destination Network Address Translation, skr. DNAT), która mówi, żeby podmienić adres IP pakietu z publicznego na prywatny, przypisany do serwera WWW w chronionej podsieci. W tym przypadku również utrzymywana jest w systemie odpowiednia baza, aby mechanizmy obsługi NAT wiedziały jak modyfikować pakiety stanowiące odpowiedzi na przekształcone.
-
Po wykonaniu wyszukiwania conntrack pakiet może trafić do łańcucha typu filter o priorytecie filter. Jest to miejsce, w którym można jawnie przypisać obiekt ct helper, np. pomocnik analizujący połączenie sterujące FTP.
-
Następuje podjęcie decyzji o routingu na podstawie tablic trasowania (ang. routing tables). Podprogram obsługi wykrywa, że pakiet nie jest przeznaczony dla lokalnej stacji i że należy przesłać go dalej innym interfejsem sieciowym.
-
Pakiet może trafić do łańcucha typu filter przez podpięcie forward z priorytetem mangle, gdzie może zostać oznaczony lub zmieniony.
-
Pakiet trafia do łańcucha typu filter przez podpięcie forward, gdzie znajdują się reguły ochronne.
-
Pakiet może trafić do łańcucha typu filter przez podpięcie postrouting z priorytetem mangle, gdzie może zostać oznaczony lub zmieniony.
-
Pakiet trafia do łańcucha typu nat przez podpięcie postrouting, gdzie może być dokonana translacja sieciowego adresu źródłowego (ang. Source Network Address Translation, skr. SNAT). Nie trafia na żadną pasującą regułę, więc nie zostaje zastosowany NAT.
-
Pakiet trafia do podprogramu obsługi reguł XFRM, odpowiedzialnego za przekształcanie datagramów. Tu dokonywane są np. zmiany zawartości i nagłówków, jeżeli wykorzystywany jest zbiór protokołów ochronnych IP Security (ang. Internet Protocol Security, skr. IPSec). Ponieważ w systemie nie ma określonych zasad XFRM, więc pakiet jest przekazywany dalej w niezmienionej formie.
-
Pakiet jest kapsułkowany w ramkę zaadresowaną do stacji sieciowej będącej serwerem WWW.
-
Jeżeli skonfigurowano łańcuch netdev egress, pakiet jest w nim przetwarzany po obsłudze warstwy sieciowej, ale przed kolejką egress klasy qdisc podsystemu QoS. Następnie ramka trafia do tej kolejki.
-
Ramka trafia do interfejsu sieciowego
eth1, gdzie jest transmitowana w medium do docelowej stacji sieciowej.
Architektura
Najogólniejszymi (zawierającymi pozostałe) strukturami nftables są tabele (ang. tables). Służą do przechowywania łańcuchów reguł, zbiorów, map, tablic przepływów (ang. flowtables) i obiektów stanowych. O zbiorach powiemy w dalszej części, a teraz warto wspomnieć, że łańcuchy reguł nie różnią się pod względem przeznaczenia od tych, które znamy z iptables czy ipchains – pozwalają grupować reguły.
Pakiety sieciowe z podsystemu Netfilter dzięki podpięciom trafiają do wybranych przez administratora łańcuchów, a w nich są przetwarzane przez każdą kolejną regułę, aż do momentu, gdy w którejś dojdzie do decyzji, że nie powinny być już analizowane.
Funkcją reguł jest badanie, czy pakiety można dopasować do kryteriów zawartych w tzw. wyrażeniach dopasowujących. W przypadku pozytywnego dopasowania wykonywane są umieszczone w regułach instrukcje (ang. statements). Istnieje kilka rodzajów instrukcji, a najpopularniejsze dotyczą podejmowania decyzji w sprawie dalszego losu pakietu. Decyzje nazywane są też werdyktami, a ich symboliczny zapis instrukcjami decyzyjnymi.
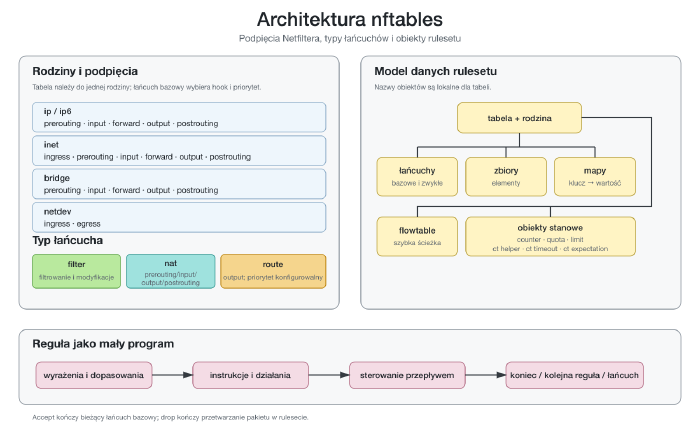
Schemat ilustrujący architekturę nftables w kontekście ścieżek przepływu i podpięć mechanizmu Netfilter
Lewa część schematu pokazuje rodziny protokołów, dostępne w nich podpięcia oraz trzy typy łańcuchów bazowych. Nie każda kombinacja jest poprawna: typ route działa wyłącznie z podpięciem output, zaś typ nat jest przeznaczony dla podpięć związanych z translacją adresów.
Po prawej stronie widać model danych rulesetu. Tabela należy do jednej rodziny i stanowi przestrzeń nazw dla łańcuchów, zbiorów, map, tablic przepływów oraz obiektów stanowych. Dolna część przypomina natomiast, że reguła jest małym programem: bada pakiet przy pomocy wyrażeń, wykonuje instrukcje i może wydać werdykt albo przekazać sterowanie dalej.
W przeciwieństwie do iptables, nftables nie tworzy z góry tabel o nazwach
filter, nat czy mangle ani wbudowanych łańcuchów. Nazwy tabel i łańcuchów należą
do administratora; o miejscu wykonania decydują rodzina, podpięcie i priorytet.
Tabele
Tabela (ang. table) jest kontenerem zawierającym łańcuchy reguł, zbiory, mapy, tablice przepływów i obiekty stanowe. Ma nazwę i przypisaną rodzinę protokołu (ang. protocol family). Rozróżnienie pod względem rodzin protokołów jest konieczne, ponieważ mamy do czynienia z odmiennymi sposobami adresowania, możliwymi do zastosowania testami i różnymi podpięciami podsystemu Netfilter.
Możliwe rodziny protokołów to:
-
ip – protokół internetowy w wersji 4 (ang. Internet Protocol version 4, skr. IPv4);
-
ip6 – protokół internetowy w wersji 6 (ang. Internet Protocol version 6, skr. IPv6);
-
inet – protokół internetowy (hybryda łącząca IPv4 i IPv6);
-
arp – protokół odwzorowywania adresów (ang. Address Resolution Protocol, skr. ARP);
-
bridge – protokoły związane z mostkami sieciowymi (ang. network bridges);
-
netdev – obsługa ruchu bezpośrednio przy interfejsie sieciowym, zanim pakiet przejdzie przez zwykłą ścieżkę stosu sieciowego lub podczas jego opuszczania.
Łańcuchy reguł
Łańcuch reguł (ang. rule chain) to struktura zawierająca uszeregowane reguły, których zadaniem jest analiza przepływających pakietów. Istnieją dwa rodzaje łańcuchów:
- łańcuchy zwykłe (ang. regular chains);
- łańcuchy bazowe (ang. base chains).
Te pierwsze mogą być używane w celu bardziej przejrzystej organizacji reguł – można wysyłać do nich pakiety korzystając z instrukcji decyzyjnej o nazwie jump.
Łańcuchy bazowe służą do przechwytywania pakietów ze wskazanych miejsc ścieżki przepływu Netfiltera. Tworząc je należy podać:
-
typ łańcucha, którym może być:
- filter – oznaczający łańcuch filtrujący pakiety;
- nat – oznaczający łańcuch służący translacji adresów (NAT); przechodzi przez niego tylko pierwszy pakiet przepływu, a kolejne korzystają z zapamiętanego powiązania; z tego powodu nie należy w nim umieszczać reguł filtrujących;
- route – oznaczający łańcuch, którego zmiana pakietu może spowodować ponowne wyznaczenie trasy; typ ten jest dostępny wyłącznie z podpięciem output;
-
podpięcie – określające miejsce mechanizmu Netfilter, w które łańcuch ma być włączony:
- prerouting – pakiety przed podjęciem decyzji o trasowaniu (wszystkie pakiety wchodzące do systemu);
- input – pakiety kierowane do tego systemu;
- forward – pakiety dla innego systemu, dla których ten jest routerem;
- output – pakiety pochodzące z tego systemu;
- postrouting – pakiety po podjęciu decyzji o routingu (wszystkie pakiety opuszczające system);
-
priorytet – będący liczbą całkowitą albo nazwą symboliczną decydującą o kolejności wykonywania łańcuchów podpiętych w tym samym miejscu. Priorytet jest częścią deklaracji łańcucha bazowego; gdy dwa łańcuchy mają tę samą wartość, ich wzajemna kolejność nie jest określona.
W przypadku tabel obsługujących protokół ARP możemy używać podpięć input i output. Rodzina bridge udostępnia prerouting, input, forward, output i postrouting, a rodzina netdev podpięcia ingress i egress. Od kernela 5.10 rodzina inet udostępnia dodatkowo ingress, działające w tym samym miejscu co netdev ingress, lecz pozwalające współdzielić zbiory i mapy z pozostałymi łańcuchami rodziny inet.
Warto też pamiętać o różnicy między werdyktami. Drop kończy przetwarzanie pakietu w regułach Netfiltera. Accept kończy bieżący łańcuch bazowy, ale nie gwarantuje, że późniejszy łańcuch podpięty w tym samym miejscu i z wyższym priorytetem nie odrzuci pakietu.
Typy danych
Podczas wyrażania parametrów reguł umieszczonych w łańcuchach korzysta się z określonych i zrozumiałych przez nftables typów danych (ang. data types). Ich symboliczna reprezentacja zostanie w procesie kompilacji zmieniona w odpowiednie struktury pseudokodu.
Pamięciowe obiekty większości typów mają stały rozmiar, ale zdarzają się takie, dla których obszar pamięci jest przydzielany dynamicznie (np. łańcuchy tekstowe).
Typy podstawowe
Typy danych pozwalają narzędziu nft sprawdzać zgodność wartości, tłumaczyć symbole i kodować wynik do niskopoziomowych obiektów oraz atrybutów interfejsu Netlink. Ich zestaw rozwija się wraz z obsługą kolejnych protokołów i metadanych, dlatego poniższa lista jest celowo reprezentatywna, a nie wyczerpująca:
| Obszar zastosowania | Przykładowe typy | Co opisują |
|---|---|---|
| wartości ogólne | integer, bitmask, string |
liczby, maski bitowe i łańcuchy tekstowe |
| data i czas | time, day, hour |
chwile, względny czas oraz składniki kalendarza |
| adresy i warstwa łącza | ipv4_addr, ipv6_addr, ether_addr, lladdr, ether_type |
adresy warstwy sieciowej i łącza oraz typ przenoszonego protokołu |
| protokoły i usługi | nf_proto, inet_proto, inet_service |
rodziny sieciowe, protokoły warstwy transportowej i numery usług |
| interfejsy i urządzenia | iface_index, ifname, iface_type, ifkind, devgroup_type |
indeksy, nazwy, rodzaje i grupy interfejsów |
| system, routing i QoS | uid, gid, mark, realm, tc_handle, pkt_type |
właścicieli gniazd, znaczniki, dziedziny trasowania, priorytety i rodzaje pakietów |
| pola protokołów | tcp_flag, icmp_type, icmp_code, icmpv6_type, icmpv6_code, arp_op, dccp_pkttype |
symboliczne wartości pól nagłówków i komunikatów protokołów |
| śledzenie połączeń | ct_state, ct_dir, ct_status, ct_event, ct_label, ct_id |
stan, kierunek, status, zdarzenia, etykiety i identyfikatory wpisów conntrack |
| sterowanie | verdict |
decyzje, np. accept, jump i return |
Podział ten jest funkcjonalnym przewodnikiem, a nie hierarchią wewnętrznych klas czy struktur. Niektóre typy bazują na innych – na przykład ct_state jest maską bitową, zaś ipv4_addr liczbą o ustalonej szerokości – ale zachowują własne reguły parsowania, nazwy symboliczne i kontrolę zgodności.
Nazwa stacji może zostać rozwiązana przez narzędzie podczas wczytywania reguł, ale nie tworzy to dynamicznego powiązania z DNS. Do aktywnego zestawu trafiają konkretne adresy uzyskane w danej chwili. Z tego powodu w regułach, które mają działać deterministycznie, lepiej używać adresów albo jawnie zarządzanych zbiorów.
W definicjach zbiorów i map można podać nazwę typu lub użyć konstrukcji typeof,
która wyprowadza go z wyrażenia, np. typeof ip saddr. Szczegóły dotyczące
danego wyrażenia i jego typu pokazuje polecenie nft describe, na przykład:
nft describe ip saddr
nft describe meta iifname
nft describe ip saddr
nft describe meta iifname
Zbiory i mapy
Nftables wyposażono w wydajne struktury służące do przechowywania danych: zbiory i mapy. Nie są one typami danych, lecz obiektami rulesetu parametryzowanymi typem elementu albo parą typów klucza i wartości. Podczas ich tworzenia trzeba określić, jakie wartości będą w nich przechowywane.
Zbiory
Zbiory (ang. sets) to kolekcje elementów, które pozwalają przechowywać i wyszukiwać informacje, np. adresy, numery portów czy nazwy interfejsów. Danych tych można następnie używać jako kryteriów dopasowania lub parametrów instrukcji.
Kernel dobiera implementację zbioru do jego właściwości. Administrator opisuje
potrzebne zachowanie przez typ, flagi oraz opcjonalną politykę performance albo
memory, zamiast wybierać konkretny rodzaj drzewa czy tablicy mieszającej.
Istnieją zbiory anonimowe (ang. anonymous sets) oraz zbiory nazwane
(ang. named sets). Te pierwsze są osadzone w regule, np. tcp dport { 22, 443 },
i nie można odwoływać się do nich z innych reguł. Są niezmienne i znikają
razem z regułą. Zbiór nazwany ma własną tożsamość, może być współdzielony
i aktualizowany niezależnie:
set dobre-adresy {
    type ipv4_addr;
    elements = { 192.168.0.1, 172.30.0.5 }
}
set dobre-adresy {
    type ipv4_addr;
    elements = { 192.168.0.1, 172.30.0.5 }
}
W zbiorach można przechowywać wiele typów danych obsługiwanych przez nftables.
Możliwe są również złączenia, np. ipv4_addr . inet_service, dzięki którym
jeden element może reprezentować parę adresu i portu.
Mapy
Mapy (ang. maps) kojarzą klucze z wartościami. Są naturalnym rozwinięciem zbiorów: zamiast odpowiadać tylko na pytanie, czy klucz istnieje, zwracają przypisaną mu wartość. Poniższa mapa pozwala ustalać znacznik na podstawie portu docelowego:
map znaczniki-uslug {
    type inet_service : mark;
    elements = { 22 : 0x1, 443 : 0x2 }
}
map znaczniki-uslug {
    type inet_service : mark;
    elements = { 22 : 0x1, 443 : 0x2 }
}
Może zostać użyta w regule następująco:
meta mark set tcp dport map @znaczniki-uslug
meta mark set tcp dport map @znaczniki-uslug
Mapy mogą być nazwane, jak w powyższym przykładzie, albo anonimowe i osadzone bezpośrednio w wyrażeniu.
Mapy decyzyjne
Mapa decyzyjna (ang. verdict map, skr. vmap) jest mapą, której wartościami są werdykty. Można myśleć o niej jak o słowniku kierującym przetwarzanie do odpowiedniej gałęzi:
meta l4proto vmap {
    tcp : jump obsluga-tcp,
    udp : jump obsluga-udp
}
meta l4proto vmap {
    tcp : jump obsluga-tcp,
    udp : jump obsluga-udp
}
Mapa nazwana ma typ wartości verdict i jest przywoływana przez
vmap @nazwa. Mapa anonimowa, taka jak powyżej, stanowi część reguły; nie
jest osobnym obiektem pozbawionym nazwy.
Interwały (zakresy)
Interwały (ang. intervals) pozwalają określać zakresy wartości. Wyrażane są
zapisem wartość-wartość i mogą pojawiać się w zbiorach, mapach oraz
bezpośrednio w regułach:
set sieci-lokalne {
    type ipv4_addr;
    flags interval;
    auto-merge;
    elements = { 192.168.0.0/24, 172.30.0.0/16 }
}
set sieci-lokalne {
    type ipv4_addr;
    flags interval;
    auto-merge;
    elements = { 192.168.0.0/24, 172.30.0.0/16 }
}
Nakładające się interwały nie tworzą reguły „najwęższy zakres wygrywa”. Bez
auto-merge konflikt jest odrzucany. W zbiorze z włączonym
auto-merge zgodne, stykające się lub nakładające zakresy mogą zostać
połączone. W mapie zakresy prowadzące do różnych wartości nie mogą nakładać się
w sposób niejednoznaczny.
Zbiory dynamiczne
Nazwany zbiór może mieć limit rozmiaru, domyślny czas ważności oraz osobny czas
ważności dla każdego elementu. Flaga timeout pozwala kernelowi usuwać
przeterminowane elementy, zaś instrukcje add i update umożliwiają
aktualizowanie zbioru podczas przetwarzania pakietów:
set czasowo-blokowane {
    type ipv4_addr;
    flags timeout;
    timeout 10m;
    size 65535;
}

ip saddr 192.0.2.0/24 update @czasowo-blokowane { ip saddr timeout 10m }
set czasowo-blokowane {
    type ipv4_addr;
    flags timeout;
    timeout 10m;
    size 65535;
}

ip saddr 192.0.2.0/24 update @czasowo-blokowane { ip saddr timeout 10m }
Taki zbiór jest stanem zapory, a nie tylko skróconym zapisem stałej listy. Jego rozmiar i czas życia elementów powinny być ograniczone, ponieważ dane mogą pochodzić bezpośrednio z drogi pakietu.
Obiekty stanowe
Do tabel należą również obiekty stanowe (ang. stateful objects), którym nadano
nazwy, aby wiele reguł mogło korzystać z tego samego stanu. Najprostszymi przykładami
są liczniki (counter), limity (limit) i kwoty (quota). Instrukcja
counter umieszczona bezpośrednio w regule utrzymuje stan lokalny dla tej reguły,
natomiast counter name odrzucone odwołuje się do nazwanego obiektu tabeli.
Do obiektów stanowych należą też konfiguracje mechanizmu śledzenia połączeń: ct helper, ct timeout oraz ct expectation. Pomocnik FTP można na przykład zdefiniować, a następnie jawnie przypisać do połączenia sterującego:
ct helper ftp-standard {
    type "ftp" protocol tcp;
}

chain pomocnicy {
    type filter hook prerouting priority filter;

    ip daddr 192.0.2.10 tcp dport 21 ct helper set "ftp-standard"
}
ct helper ftp-standard {
    type "ftp" protocol tcp;
}

chain pomocnicy {
    type filter hook prerouting priority filter;

    ip daddr 192.0.2.10 tcp dport 21 ct helper set "ftp-standard"
}
Samo przypisanie pomocnika nie dopuszcza ruchu. Reguły filtrujące nadal muszą jawnie zaakceptować połączenie sterujące oraz oczekiwany ruch related.
Reguły
Reguły (ang. rules) w nftables składają się z wyrażeń i instrukcji. Wyrażenia odczytują lub obliczają wartości, zaś instrukcje wykonują działania. Jeżeli badany pakiet charakteryzuje się właściwościami pasującymi do kryteriów, wykonywane są kolejne instrukcje reguły, a jedna z nich może zakończyć dalsze przetwarzanie.
Wyrażenia
Wyrażenia (ang. expressions), jak sama nazwa wskazuje, pozwalają wyrażać pewne wartości. Wartości te mogą być stałe (np. adresy sieciowe czy numery portów), albo wyliczone (np. dane powstałe wcześniej w toku badania zawartości pakietu bądź informacje kernela dotyczące trasowania lub śledzenia połączeń). Każda stała wartość wyrażenia ma jakiś znany typ danych, podobnie jak każda wartość wyrażenia, które zostało już obliczone.
Wyrażeń używa się przede wszystkim w regułach, aby konstruować kryteria dopasowywania (ang. match criteria) pakietów, jednak znajdują one również zastosowanie w dookreślaniu instrukcji, np. podczas parametryzowania translacji adresów.
Wyrażenia mogą składać się z innych wyrażeń, a ich spoiwem są wtedy odpowiednie operatory. Powstają wtedy wyrażenia złożone (ang. combined expressions).
Na potrzeby dalszego opisu możemy zachować następującą klasyfikację:
-
wyrażenia podstawowe, opisujące pojedynczą wartość:
- stałe – adresy, porty, liczby, maski i nazwy symboliczne;
- niestałe, których wartość jest odczytywana podczas obsługi pakietu:
- metadanowe – informacje kernela niezapisane bezpośrednio w pakiecie;
- ładunkowe – pola nagłówków protokołów;
- śledzenia połączeń – dane podsystemu conntrack;
-
wyrażenia złożone, budowane z innych wyrażeń:
- operacje bitowe;
- przedrostki;
- zakresy;
- listy;
- złączenia;
-
wyrażenia relacyjne, które odpowiadają na pytanie o zależność między wartościami:
- proste porównania;
- dopasowania flag.
Jest to klasyfikacja dydaktyczna, a nie zamknięta hierarchia parsera. Jej gałęzie częściowo się przecinają: wyrażenie ładunkowe może być składnikiem złączenia, a całe złączenie jedną ze stron porównania. Współczesne nftables zawiera także wyspecjalizowane wyrażenia dotyczące m.in. trasowania, gniazd, FIB, generowania liczb, haszowania i systemu operacyjnego rozpoznanego po cechach stosu TCP.
Wyrażenia podstawowe
Wyrażenia stałe
Wyrażenia stałe to niezmienne wartości, np. adres 192.168.0.1, port
443, stan established albo nazwa interfejsu "eth0".
Symbole są tłumaczone w przestrzeni użytkownika podczas wczytywania reguł.
Wyrażenia niestałe
Wyrażenia metadanowe
Wyrażenia metadanowe odczytują informacje związane z pakietem, ale niekoniecznie zapisane w jego nagłówku. Poniższa tabela zawiera najczęściej używane parametry:
| Wyrażenie | Typ wyniku | Znaczenie |
|---|---|---|
meta length |
integer (32 bity) |
długość pakietu w bajtach |
meta nfproto |
integer (32 bity) |
rzeczywista rodzina protokołu, przydatna w tabeli inet |
meta l4proto |
integer (8 bitów) |
protokół warstwy transportowej, z pominięciem nagłówków rozszerzeń IPv6 |
meta protocol |
ether_type |
typ protokołu przenoszonego w ramce |
meta mark |
mark |
znacznik pakietu |
meta iif, meta oif |
iface_index |
indeks interfejsu wejściowego lub wyjściowego |
meta iifname, meta oifname |
ifname |
nazwa interfejsu wejściowego lub wyjściowego |
meta skuid, meta skgid |
uid, gid |
właściciel gniazda, z którego pochodzi lokalny pakiet |
meta pkttype |
pkt_type |
typ pakietu, np. host, broadcast albo multicast |
Indeks i nazwa interfejsu nie są równoważne. Reguła korzystająca z iif lub
oif może zostać dodana dopiero wtedy, gdy interfejs istnieje; pozostanie jednak
związana z tym samym urządzeniem po zmianie jego nazwy. iifname i oifname
dopasowują nazwę, więc sprawdzą się również w regułach przygotowanych przed
utworzeniem dynamicznego interfejsu, lecz przestaną pasować po jego przemianowaniu.
Słowo meta może zostać pominięte tam, gdzie pozostała część wyrażenia jest
jednoznaczna, jednak zapis doprecyzowany bywa łatwiejszy do czytania.
Wyrażenia ładunkowe
Wyrażenia ładunkowe odczytują pola nagłówków. Protokół i nazwa pola tworzą wtedy
naturalną parę, np. ip saddr, ip6 daddr,
tcp dport, udp length, ether saddr czy
vlan id.
| Wyrażenie | Typ wyniku | Znaczenie |
|---|---|---|
arp operation |
arp_op |
operacja ARP, np. request albo reply |
ether saddr, ether daddr |
ether_addr |
źródłowy lub docelowy adres Ethernet |
ether type |
ether_type |
typ protokołu przenoszonego w ramce |
ip saddr, ip daddr |
ipv4_addr |
źródłowy lub docelowy adres IPv4 |
ip dscp, ip ecn |
dscp, ecn |
pola klasy usług i jawnego powiadamiania o przeciążeniu |
ip6 saddr, ip6 daddr |
ipv6_addr |
źródłowy lub docelowy adres IPv6 |
ip6 nexthdr |
inet_proto |
protokół bezpośrednio następnego nagłówka IPv6 |
tcp sport, tcp dport |
inet_service |
źródłowy lub docelowy port TCP |
tcp flags |
tcp_flag |
flagi TCP, np. syn, ack albo rst |
udp sport, udp dport |
inet_service |
źródłowy lub docelowy port UDP |
vlan id |
integer (12 bitów) |
identyfikator VLAN |
Nie należy utożsamiać ip6 nexthdr z „dowolnym protokołem transportowym
przenoszonym przez IPv6”. Pole to opisuje bezpośrednio następny nagłówek i może
wskazywać nagłówek rozszerzeń. Wyrażenie meta l4proto uwzględnia przejście
przez typowe nagłówki rozszerzeń i zwykle lepiej nadaje się do rozróżniania TCP, UDP
czy ICMPv6.
Wyrażenia śledzenia połączeń
Wyrażenia conntrack udostępniają m.in. stan, kierunek, status, znaczniki, etykiety, czas ważności oraz krotki obu kierunków połączenia:
| Wyrażenie | Typ wyniku | Znaczenie |
|---|---|---|
ct state |
ct_state |
stan połączenia, np. new, established, related albo invalid |
ct direction |
ct_dir |
kierunek pakietu względem połączenia: original albo reply |
ct status |
ct_status |
znaczniki statusu wpisu śledzenia połączenia |
ct mark |
mark |
znacznik połączenia |
ct expiration |
time |
czas pozostały do wygaśnięcia wpisu |
ct helper |
string |
skojarzony moduł pomocniczy conntrack |
ct original l3proto, ct reply l3proto |
nf_proto |
protokół warstwy sieciowej dla wybranego kierunku |
ct original ip saddr, ct reply ip daddr |
ipv4_addr |
adres IPv4 z krotki wybranego kierunku |
ct original ip6 saddr, ct reply ip6 daddr |
ipv6_addr |
adres IPv6 z krotki wybranego kierunku |
ct original protocol, ct reply protocol |
inet_proto |
protokół warstwy transportowej wybranego kierunku |
ct original proto-src, ct reply proto-dst |
integer (16 bitów) |
port albo inny identyfikator warstwy transportowej |
ct packets, ct original bytes, ct reply avgpkt |
integer (64 bity) |
liczniki dla jednego kierunku albo ich suma |
ct zone, ct original zone, ct reply zone |
integer (16 bitów) |
strefa conntrack |
ct count, ct id |
integer (32 bity), ct_id |
liczba bieżących połączeń albo identyfikator wpisu |
Najczęściej spotykany przykład to:
ct state established,related accept
ct state established,related accept
Pełny zestaw parametrów zależy od wersji narzędzia i kernela. Również tutaj
najpewniejszą dokumentacją lokalnej instalacji jest nft describe, np.
nft describe ct state.
Wyrażenia złożone
Wyrażenia złożone, jak sama nazwa mówi, składają się z innych wyrażeń i operacji, które nadają im sens obliczeniowy.
Wyrażenia operacji bitowych
Wyrażenia operacji bitowych pozwalają przeprowadzać działania na pojedynczych bitach wartości podanych wyrażeń. Składają się z operatora i dwóch operandów, które powinny być wartościami o typach numerycznych:
| Operator | Znaczenie |
|---|---|
& | koniunkcja
bitowa (iloczyn logiczny, operacja AND) |
| | | alternatywa bitowa (suma logiczna, operacja OR) |
^ | bitowa różnica
symetryczna (logiczna alternatywa wykluczająca, operacja XOR) |
Wyrażenia przedrostkowe
Dzięki wyrażeniom przedrostkowym można zapisywać na przykład prefiksy sieci. Składają
się z dwóch argumentów oddzielonych znakiem ukośnika (/). Wartość pierwszego
argumentu powinna być adresem lub typem numerycznym, a drugiego liczbą całkowitą
określającą liczbę bitów pierwszego, które są istotne (np. powinny być pozostawione
podczas wyliczania części adresu IP wskazującego na sieć).
Wyrażenia zakresowe
Wyrażenia zakresowe obsługiwane są przez interwały omówione przy okazji
przedstawiania zbiorów i map. Składają się z dwóch argumentów typu numerycznego
(wyrażeń wartościowanych do typu numerycznego) oddzielonych dywizem (-).
Wyrażenia listowe
Wyrażenia listowe, zwane także listami wyrażeń są listami kolejnych wyrażeń
oddzielonych znakami przecinka (,). Znaczenie takiej listy zależy od typu. Dla
maski bitowej zapis tcp flags syn,ack pasuje, gdy ustawiono syn, ack albo
obie flagi; pozostałe bity są ignorowane. Nie jest to to samo co wyszukanie wartości
w zbiorze: tcp flags { syn, ack } pasuje wyłącznie do pakietu z samą flagą
syn albo samą flagą ack.
Gdy wymienione bity są wzajemnie wykluczające, oba zapisy mogą dawać ten sam
rezultat. Dlatego ct state established,related działa zgodnie z intuicją jako
dopasowanie jednego z dwóch stanów.
Wyrażenia złączeniowe
Dzięki wyrażeniom złączeniowym możliwe jest tworzenie wyrażeń, których wartości zostaną połączone w jeden łańcuch. Może być to przydatne na przykład podczas tworzenia kluczy dla zbiorów odzwierciedlających wielowymiarowe struktury lub podczas dopasowywania sąsiadujących pól nagłówków.
Wyrażenie złączeniowe można tworzyć na bazie dwóch lub więcej wyrażeń, między którymi
znajduje się znak kropki (.).
Wyrażenia relacyjne
Wyrażenia relacyjne, zwane też wyrażeniami dopasowującymi (ang. match expressions), pozwalają na sprawdzanie zależności i związków między wartościami. Dzięki nim możliwe jest warunkowanie wykonania pewnych czynności, np. jeżeli badany pakiet spełni określone kryteria.
Istnieją dwa rodzaje wyrażeń dopasowujących:
- proste wyrażenia relacyjne (ang. basic relational expressions);
- porównania flag (ang. flag comparisons).
Proste wyrażenia relacyjne
Proste wyrażenia relacyjne polegają na użyciu operatora (ang. operator) komunikującego relację między wyrażeniami umieszczonymi po jego lewej i prawej stronie:
| Operator | Znaczenie |
|---|---|
== | równe |
!= | różne |
< | mniejsze |
<= | mniejsze lub równe |
> | większe |
>= | większe lub równe |
Jeżeli nie podano operatora, domniemywa się, że chodzi
o ==.
W przypadku, gdy wyrażeniem po prawej stronie jest zbiór, dokonywane jest jego przeszukanie pod kątem zawierania określonego elementu, podobnie w przypadku gdy jest to zakres (interwał).
Dopasowania flag
Drugim rodzajem wyrażeń dopasowujących są dopasowania flag. Flagi to jednobitowe elementy, które mogą wyrażać logiczną prawdę lub fałsz. W strukturach pakietów i ramek rozmaite flagi łączy się w jedno- lub nawet wielobajtowe łańcuchy. Powstają wtedy struktury, które chociaż dają się reprezentować numerycznie (jako liczby całkowite), są w istocie zestawami parametrów, a znaczenie każdego z nich zależy od umiejscowienia w sekwencji.
Aby zbadać, czy wszystkie wybrane flagi są ustawione, trzeba zamaskować pozostałe bity i porównać wynik z oczekiwanym wzorcem. Zapis po lewej stronie ukośnika określa oczekiwaną wartość, a zapis po prawej maskę:
tcp flags syn,ack / syn,ack
tcp flags syn,ack / syn,ack
Symbole takie jak syn, ack, established czy related pozwalają nie korzystać
z liczbowych wartości masek. Trzeba jednak odróżniać test pojedynczego bitu, test
co najmniej jednego bitu z listy, test wszystkich wskazanych bitów oraz wyszukanie
całej wartości w zbiorze.
Instrukcje i werdykty
Dzięki temu, że zamiast z regułami o ustalonej strukturze mamy do czynienia z małymi pseudoprogramami, możemy bez tworzenia dodatkowych łańcuchów czy osobnych reguł sprawiać, aby w stosunku do pakietu spełniającego określone kryteria było podejmowanych więcej niż jedno działanie. Wyrażenia odczytują dane i budują kryteria, natomiast instrukcje (ang. statements) wykonują działania, np. zliczają, raportują, ustawiają znacznik albo sterują dalszym przetwarzaniem. Podział ten istnieje w języku nft, nawet jeżeli po kompilacji oba rodzaje konstrukcji stają się niskopoziomowymi instrukcjami maszyny wirtualnej kernela.
Niektóre instrukcje decydują o losie pakietu – nazywamy je wtedy decyzjami lub werdyktami (ang. verdicts), a wyrażające je konstrukcje instrukcjami decyzyjnymi (ang. verdict statements).
Poniżej przedstawiono kilka najczęściej używanych instrukcji; nie jest to lista wyczerpująca:
-
decyzje (werdykty):
- accept – przyjęcie pakietu;
- drop – zablokowanie pakietu;
- continue – kontynuowanie od następnej reguły;
- return – zwrócenie pakietu do łańcucha nadrzędnego;
- jump – wywołanie podanego łańcucha z możliwością powrotu;
- goto – przejście do podanego łańcucha bez zapamiętania miejsca powrotu;
-
odrzucanie z odpowiedzią:
- reject – zakończenie przetwarzania i odrzucenie pakietu z poinformowaniem nadawcy; jest instrukcją terminalną, ale nie werdyktem używanym np. jako wartość mapy decyzyjnej;
-
translacje adresów:
- snat – translacja adresu źródłowego pakietu (SNAT);
- dnat – translacja adresu docelowego pakietu (DNAT);
- masquerade – SNAT korzystający z adresu interfejsu wyjściowego;
- redirect – przekierowanie do lokalnej stacji;
-
modyfikacje:
- meta mark – ustawianie znacznika pakietu;
- meta priority – ustawianie priorytetu (klasyfikacja QoS);
- meta nftrace – włączanie śledzenia ścieżki w obrębie nf_tables;
-
warunkowanie limitem częstotliwości:
- limit rate – dopasowanie oparte na mechanizmie token bucket; samo nie kolejkuje ani nie odrzuca pakietów, lecz warunkuje wykonanie kolejnych instrukcji;
-
raportowanie:
- log – zgłoszenie pakietu do podsystemu raportowania zdarzeń;
-
zliczanie:
- counter – zliczanie pakietów (w nftables opcjonalne).
Instrukcje mogą decydować o losie pakietu, ale mogą też zmieniać stan zapory albo pakietu. Życiowym przykładem może tu być konieczność raportowania i jednoczesnego oznaczania pakietów – w nftables robi się to z użyciem jednego polecenia.
Niektóre instrukcje reguł nftables można parametryzować, a parametry mogą być ustalane dynamicznie, na podstawie danych uzyskanych w toku analizy pakietu lub przez odczyt struktur utrzymywanych przez jądro (np. tabel śledzenia połączeń). W praktyce pozwala to na zarządzanie ruchem sieciowym w sposób niezwykle elastyczny.
Współczesna praktyka
W typowej zaporze dla stacji lub serwera warto zacząć od rodziny inet, która
pozwala wspólnie obsługiwać IPv4 i IPv6. Nie oznacza to, że każde wyrażenie pasuje
do obu protokołów: ip saddr nadal dotyczy IPv4, a ip6 saddr
IPv6. Wspólne mogą być natomiast łańcuchy, stany conntrack, porty i wiele
metadanych.
Reguły najlepiej przechowywać w pliku i wczytywać jako jedną transakcję. Polecenie:
nft -c -f /etc/nftables.conf
nft -c -f /etc/nftables.conf
sprawdza cały plik bez zastosowania zmian, a po usunięciu opcji -c
wczytuje go atomowo. Błąd w jednym poleceniu powoduje odrzucenie całej transakcji.
Podczas pracy przez SSH należy zachować dodatkowy kanał odzyskiwania lub zaplanowany
powrót do poprzednich reguł, ponieważ poprawna składnia nie gwarantuje zachowania
dostępu administracyjnego.
Przydatne współczesne mechanizmy to m.in.:
- nazwane zbiory i mapy, także z czasem ważności i aktualizacją z drogi pakietu;
- złączenia, pozwalające jednym wyszukaniem dopasować np. adres, protokół i port;
- uchwyty reguł, widoczne po użyciu
nft -a list ruleseti pozwalające precyzyjnie usunąć albo zastąpić regułę; - śledzenie, które można włączyć przez
meta nftrace set 1i obserwować poleceniemnft monitor trace; - przegląd aktywnych podpięć poleceniem
nft list hooks, pokazującym rzeczywistą kolejność łańcuchów oraz funkcji kernelowych, takich jak conntrack i NAT; - tablice przepływów (ang. flowtables), tworzące szybką drogę przekazywania ustalonych przepływów;
- libnftables i reprezentacja JSON, pozwalające programom zarządzać regułami bez
analizowania tekstowego wyniku polecenia
nft.
W jednym systemie często spotykają się nft, zgodnościowe polecenia iptables-nft, menedżery takie jak firewalld oraz oprogramowanie kontenerowe. Technicznie mogą one tworzyć osobne tabele i łańcuchy, ale nie powinny bez uzgodnienia zarządzać tym samym fragmentem rulesetu. Nazwy tabel nie wyznaczają osobnych zapór: ostateczny wynik zależy od wszystkich łańcuchów podpiętych do danego punktu, ich priorytetów i werdyktów.
Podsumowanie
Przykład kompletnego pliku
Poniższy niewielki ruleset nie blokuje ruchu: zachowuje politykę accept,
zlicza nowe połączenia spoza lokalnej sieci i oznacza pakiety pochodzące z dwóch
wskazanych adresów. Używa wspólnej dla IPv4 i IPv6 rodziny inet, choć oba
dopasowania adresu dotyczą świadomie tylko IPv4:
table inet nasza {
    set dobre-adresy {
        type ipv4_addr;
        elements = { 192.168.0.1, 172.30.0.5 }
    }

    chain wejscie {
        type filter hook input priority filter; policy accept;

        ct state new ip saddr != 192.168.0.0/24 counter
        ip saddr @dobre-adresy meta mark set 31337
    }
}
table inet nasza {
    set dobre-adresy {
        type ipv4_addr;
        elements = { 192.168.0.1, 172.30.0.5 }
    }

    chain wejscie {
        type filter hook input priority filter; policy accept;

        ct state new ip saddr != 192.168.0.0/24 counter
        ip saddr @dobre-adresy meta mark set 31337
    }
}
Plik zapisany jako /tmp/nasza.nft można najpierw sprawdzić, a następnie
wczytać:
nft -c -f /tmp/nasza.nft
nft -f /tmp/nasza.nft
nft -a list table inet nasza
nft -c -f /tmp/nasza.nft
nft -f /tmp/nasza.nft
nft -a list table inet nasza
Przykład celowo nie zawiera flush ruleset. Takie polecenie jest właściwe
wyłącznie wtedy, gdy dany plik jest jedynym właścicielem całej konfiguracji
nftables; w przeciwnym razie usunęłoby także reguły utworzone przez inne
narzędzia.
Zobacz także:
- „The netfilter.org nftables project”, strona projektu
- „Nftables manual”, aktualny podręcznik referencyjny
- „Nftables HOWTO”, HOWTO projektu
- „Blokowanie niepożądanej komunikacji z nftables na Linux”, Morfitronik
- „Nftables quick howto”, historyczny podręcznik autorstwa Érica Leblonda
- „Why you will love nftables”, historyczny wpis w blogu Érica Leblonda
- „nftables”, podręcznik nftables dystrybucji Arch Linux
- „Nftables”, podręcznik nftables dystrybucji Gentoo Linux
- "[ANNOUNCE]: First release of nftables", ogłoszenie na Netfilter Development
- „Netfilter – index : nftables”, kod źródłowy
- „gnftables”, narzędzie do graficznego zarządzania regułami (wersja rozwojowa)