
Specyficzna składnia dialektów języka Lisp pozwala precyzyjnie określać i rozróżniać podstawowe konstrukcje, dodawać nowe elementy syntaktyczne, a także przekształcać formy programu jako dane podczas rozwijania makr. Wynika to z zastosowania prostych, jednak przemyślanych sposobów organizowania i reprezentowania kodu źródłowego.
Podstawowe konstrukcje
Programy pisane w odmianach języka Lisp charakteryzują się prostymi regułami składniowymi. Zamiast dyskutować o nich teoretycznie, rozpoczniemy praktycznym przykładem, na który będziemy się powoływać w celu poznania podstawowych mechanizmów rządzących tłumaczeniem kodu źródłowego na postać zrozumiałą dla komputera. Śledząc, co robi kompilator, lepiej zrozumiemy konstrukcje języka.
Oto nasz bazowy przykład:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
Nie jest specjalnie trudny. Prawda?
Składnia
Lisp z wyglądu przypomina owsiankę
z wmieszanymi obciętymi paznokciami.
— Larry Wall
Zacznijmy od składni (ang. syntax). Pierwszym, co rzuca się w oczy, gdy widzimy programy napisane w dialektach Lispu, jest umieszczanie niemal każdej złożonej konstrukcji w nawiasach. W innych językach programowania nawiasy służą do grupowania wybranych elementów składniowych, np. argumentów podczas wywoływania bądź definiowania funkcji, zestawu warunków czy działań na wartościach. W Lispach nawiasy są podstawowym elementem leksykalnym, używanym do nadawania kształtu całemu programowi i każdemu z wyrażeń.
W językach typu Lisp konstruujemy wyrażenia z zastosowaniem tzw. notacji polskiej (ang. Polish notation, skr. PN), zwanej też zapisem przedrostkowym (ang. prefix notation). Polega ona na tym, że najpierw umieszczamy operator (nazwę funkcji), a następnie operandy (argumenty wywołania). Nawiasów używamy, aby oznaczać początki i końce wyrażeń.
Notacja przedrostkowa jest różna od popularnego w wielu językach programowania zapisu wrostkowego (ang. infix), lecz nie na tyle, żeby wielce utrudniało to rozpoznawanie poszczególnych części wyrażeń. Nasz przykładowy program możemy w Rubym przedstawić tak:
print "Witaj, Lispie!"
print "Witaj, Lispie!"
A w języku C w następujący sposób:
#include <stdio.h>

int main(int argc, char *argv[]) {
    printf("Witaj, Lispie!");
    return 0;
}
#include <stdio.h>

int main(int argc, char *argv[]) {
    printf("Witaj, Lispie!");
    return 0;
}
Różnice między omawianymi rodzajami zapisu daje się dobrze zilustrować operacjami matematycznymi. Popatrzmy na dwa proste działania:
2 + 2 * 3
2 + 2 * 3
I zapis zgodny ze składnią języka Clojure:
(+ 2 (* 2 3))
(+ 2 (* 2 3))
Możemy zauważyć, że w drugim przykładzie operator dodawania i jego operandy są ujęte w nawiasy, a operacja znajduje się na pierwszej pozycji każdej wartościowanej listy. Zaletą tego zapisu jest brak konieczności pamiętania o pierwszeństwie operatorów (ang. operator precedence).
Poza tym zapis przedrostkowy nadaje zagnieżdżonym wywołaniom jeden regularny kształt. Clojure nadal używa innych ograniczników dla literałów wektorów, map i zbiorów, ale nie potrzebuje osobnej tabeli pierwszeństwa operatorów wrostkowych. Korzyścią jest regularność gramatyki, a nie obietnica, że każdy parser zapisu przedrostkowego będzie szybszy.
Czytnik
Wróćmy do naszego programu:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
Pierwszym krokiem jest wczytanie tekstu do pamięci. Czytnik (ang. reader) pobiera następną formę ze strumienia znaków i zwraca reprezentowaną przez nią wartość Clojure. Otwarcie pliku lub strumienia terminalu należy do wywołującego; sam czytnik jest użyteczny niezależnie od kompilacji i wartościowania. Na potrzeby objaśnienia możemy wyróżnić dwa zadania pojęciowe:
-
związaną z wykrywaniem znanych konstrukcji leksykalnych w tekście;
-
związaną z wyodrębnianiem spośród znalezionych konstrukcji gramatycznie poprawnych wyrażeń i reprezentowaniem ich w postaci wewnętrznych, pamięciowych struktur.
Analiza leksykalna
Pierwsza faza wczytywania źródeł programu do pamięci to analiza leksykalna (ang. lexical analysis). Polega ona na:
-
oczyszczeniu wejścia ze zbędnych symboli;
-
rozpoznaniu w strumieniu znaków sekwencji pasujących do zdefiniowanych w leksykonie języka jednostek leksykalnych (ang. lexical units), w tym kontekście zwanych tokenami (ang. tokens);
-
wydzieleniu z tekstu fragmentów, które mają znaczenie składniowe (tzw. leksemów, ang. lexemes), będących swego rodzaju instancjami wykrytych tokenów.
Patrząc leksykalnie, możemy wskazać w przykładzie następujące fragmenty znaczące:
| Leksem | Nazwa tokenu |
|---|---|
( |
literał listowy (otwierający) |
print |
symbol |
"Witaj, Lispie" |
literał łańcucha znakowego |
) |
literał listowy (zamykający) |
Słownictwo to jest użytecznym modelem opisowym; nie oznacza, że Clojure udostępnia
osobny strumień tokenów lub publiczny tokenizer. Publiczna operacja read pobiera
jedną pełną formę i zwraca jej wartość.
Analiza składniowa
Drugim zadaniem pojęciowym jest parsowanie (ang. parsing). Obejmuje ono:
-
rozpoznanie w strumieniu leksemów konstrukcji składniowych (ang. syntactic constructs) przez porównanie ich rodzajów i umiejscowienia z regułami gramatycznymi języka;
-
wczytywanie zagnieżdżonych form według reguł ograniczników i znaków makrowych;
-
wytworzenie pamięciowych reprezentacji znalezionych wyrażeń z użyciem odpowiednich struktur danych;
Rezultatem są dane Clojure reprezentujące następną formę. Kompilator może później przeanalizować te dane do własnej reprezentacji wewnętrznej, lecz wynik czytnika nie jest tym AST kompilatora.
Formy czytnika
Formy czytnika (ang. reader forms) to zapisy tekstowe, które czytnik Clojure rozpoznaje i zmienia w wartości.
Poniższa tabela zawiera podstawowe formy czytnika. W pierwszej kolumnie umieszczono nazwę tokenu, w drugiej przykłady leksemów, a w ostatniej typ wartości zwracanej przez czytnik, jeżeli wejście jest poprawne.
| Nazwa tokenu | Przykłady leksemów | Typ danych |
|---|---|---|
| symbol | razprzestrzeń/dwa |
Symbol |
| literał pusty | nil |
nil |
| literał kluczowy | :raz::dwa:przestrzeń/x::przestrzeń/y |
Keyword |
| literał łańcuchowy | "raz dwa" |
java.lang.String |
| literał listowy | (1 2 3) |
PersistentList |
| literał wektorowy | [1 2 3] |
PersistentVector |
| literał mapowy | {:a 1 :b 2}#::{:a 1 :b 2}#:przestrzeń{:a 1 :b 2} |
PersistentArrayMapPersistentHashMap |
| literał logiczny | true, false |
java.lang.Boolean |
| literał liczby całkowitej | 10xff0172r1101 |
java.lang.Long |
| literał liczby wymiernej | 1/2 |
Ratio |
| literał liczby dużej | 1.2M1N |
java.math.BigDecimalBigint |
| literał liczby zmiennoprzecinkowej | -2.7e-4 |
java.lang.Double |
Makra czytnika
Niektóre znaki uruchamiają specjalne zachowanie podczas wczytywania i tradycyjnie są nazywane makrami czytnika (ang. reader macros) lub znakami makrowymi. Zachowanie Clojure łączy wbudowane reguły z wewnętrzną tabelą odczytu, której programy nie mogą modyfikować. Literały oznaczone z kwalifikowanymi znacznikami są kontrolowanym punktem rozszerzeń, który odwzorowuje znacznik na funkcję czytającą dane.
Poniższa tabela przedstawia zestawienie makr czytnika:
| Nazwa tokena | Przykłady leksemów | Wynik czytnika |
|---|---|---|
| cytowanie (ang. quote) | 'raz'(raz dwa) |
lista rozpoczynająca się od quote |
| cytowanie składniowe (ang. syntax-quote) |
`raz`(dwa trzy) |
różne |
| cofanie cytowania składniowego (ang. syntax unquote) |
~cytat |
różne |
| cofanie cytowania składniowego z rozplataniem (ang. syntax unquote-splicing) |
~@(list 1 2) |
różne |
| mapa metadanowa (ang. metadata map) |
^{:doc "Opis"} x |
następna forma z metadanymi |
| klucz metadanowy (ang. metadata key) |
^:dynamic x |
następna forma z metadanymi |
| znacznik metadanowy (ang. metadata tag) |
^Integer x |
następna forma z metadanymi |
| komentarz (ang. comment) |
; komentarz |
brak |
| literał znakowy (ang. character literal) |
\a, \b, \c, \newline |
java.lang.Character |
| wyrażenie dereferencyjne (ang. dereference expression) |
@x |
lista rozpoczynająca się od deref |
| makro dyspozycyjne (ang. dispatch macro) | #… |
różne |
Ostatnia pozycja w tabeli to tzw. makro dyspozycyjne. Jest to ogólna nazwa
określająca podgrupę makr czytnika, których wszystkie tokeny rozpoczynają się
symbolem kratki (#). Gdy czytnik zauważa ten znak, przekazuje kontrolę nad dalszą
analizą konstrukcji do oddzielnej tablicy makr. Poniżej znajduje się lista tokenów,
których obsługa odbywa się z użyciem makra dyspozycyjnego:
| Nazwa tokena | Przykłady leksemów | Wynik czytnika |
|---|---|---|
| cytowanie Varów (ang. var-quote) |
#'x |
lista rozpoczynająca się od var |
| literał zbiorowy (ang. set literal) |
#{1 2 3} |
PersistentHashSet |
| wyrażenie regularne (ang. regular expression) |
#"raz.dw[aA]" |
java.util.regex.Pattern |
| literał funkcji anonimowej (ang. anonymous function literal) |
#(pr %)#(pr %1 %2) |
lista rozpoczynająca się od fn* |
| ignorowanie następnej formy (ang. ignore next form) |
#_ raz dwa |
brak |
| literał rekordu/typu (ang. record/type literal) |
#nazwa.typ[:x]#nazwa.rekord{:x 1} |
instancja nazwanego typu Clojure |
| wyrażenie warunkowe czytnika (ang. reader conditional) |
#?(:clj "Clojure":cljs "ClojureScript") |
wybrana forma lub brak |
| literał oznaczony (ang. tagged literal) |
#symbol argument |
różne |
literał oznaczony inst(ang. inst tagged literal) |
#inst "2018-11-12" |
java.util.Date |
literał oznaczony UUID(ang. UUID tagged literal) |
#uuid "88b05082-392d-4e0a-89c9-cf62ec375c43" |
java.util.UUID |
Kilka pozycji rozwija się do zwykłych list, które dopiero później uzyskują znaczenie
wykonywalne. Przykładowo @x jest wczytywane jako (clojure.core/deref x), a #'x
jako (var x). Z kolei #_ powoduje całkowite pominięcie następnej formy. Literały
oznaczone wywołują podczas wczytywania zarejestrowane funkcje czytające dane, dlatego
wczytywanie zaufanego kodu Clojure i parsowanie niezaufanego EDN mają odmienne
kontrakty bezpieczeństwa.
S-wyrażenia
Na poziomie gramatycznym każdy element kodu źródłowego w Lispie jest symbolicznie zapisanym wyrażeniem. Tekstowe reprezentacje wyrażeń – te, które widzimy w edytorze – to tzw. wyrażenia symboliczne (ang. symbolic expressions), nazywane skrótowo S-wyrażeniami (skr. S-expressions, sexprs, sexps).
Struktura S-wyrażeń przypomina trochę XML-a bądź JSON-a, tzn. mamy do czynienia z zapisem, który pozwala wyrażać zagnieżdżone i uporządkowane zestawy wartości, chociaż w nieco prostszy sposób niż wymienione formaty.
S-wyrażenie w Lispie możemy zdefiniować jako rodzaj notacji, w której:
- każdy element jest wyrażeniem:
- niezłożonym (zwanym atomem) lub
- składającym się z S-wyrażeń ujętych w nawiasy
i oddzielonych separatorem.
print                     ; atomowe S-wyrażenie (nie lista S-wyrażeń)
"Witaj, Lispie!"          ; atomowe S-wyrażenie (nie lista S-wyrażeń)
(print "Witaj, Lispie!")  ; listowe S-wyrażenie
()                        ; listowe i atomowe S-wyrażenie jednocześnie
(print (+ 2 2))           ; S-wyrażenie złożone z zagnieżdżonych S-wyrażeń
print                     ; atomowe S-wyrażenie (nie lista S-wyrażeń)
"Witaj, Lispie!"          ; atomowe S-wyrażenie (nie lista S-wyrażeń)
(print "Witaj, Lispie!")  ; listowe S-wyrażenie
()                        ; listowe i atomowe S-wyrażenie jednocześnie
(print (+ 2 2))           ; S-wyrażenie złożone z zagnieżdżonych S-wyrażeń
S-wyrażenie w Clojure będziemy definiowali w nieco bogatszy sposób, ponieważ mamy tam do czynienia z dodatkowymi literałami kolekcji. Będzie nim rodzaj notacji, w której:
- każdy element jest wyrażeniem:
- niezłożonym (zwanym atomem) lub
- składającym się z odseparowanych S-wyrażeń:
- w parach, ujętych w nawiasy klamrowe –
{…}; - w pojedynkę, ujętych w:
- nawiasy okrągłe –
(…); - klamry z symbolem kratki –
#{…}; - nawiasy kwadratowe –
[…].
- nawiasy okrągłe –
- w parach, ujętych w nawiasy klamrowe –
W przypadku wyrażeń w nawiasach klamrowych pierwsze elementy par muszą być unikatowymi wartościami w całym wyrażeniu, a w przypadku wyrażeń w nawiasach klamrowych z symbolem kratki każda wartość musi być unikatowa. Sprawdzanie wykonywane jest już podczas analizy składniowej, a gdy podany element wymaga wcześniejszego wyliczenia, podczas ewaluacji.
:raz                      ; atomowe S-wyrażenie
1                         ; atomowe S-wyrażenie
print                     ; atomowe S-wyrażenie
"Witaj, Lispie!"          ; atomowe S-wyrażenie
(print "Witaj, Lispie!")  ; listowe S-wyrażenie
[1 2 3]                   ; wektorowe S-wyrażenie
#{1 2 3}                  ; zbiorowe S-wyrażenie
{:raz 1 :dwa 2 :trzy 3}   ; mapowe S-wyrażenie
(str [1 2 3])             ; listowe i wektorowe S-wyrażenia
:raz                      ; atomowe S-wyrażenie
1                         ; atomowe S-wyrażenie
print                     ; atomowe S-wyrażenie
"Witaj, Lispie!"          ; atomowe S-wyrażenie
(print "Witaj, Lispie!")  ; listowe S-wyrażenie
[1 2 3]                   ; wektorowe S-wyrażenie
#{1 2 3}                  ; zbiorowe S-wyrażenie
{:raz 1 :dwa 2 :trzy 3}   ; mapowe S-wyrażenie
(str [1 2 3])             ; listowe i wektorowe S-wyrażenia
Rekurencyjna definicja S-wyrażenia może wydawać się mało zrozumiała, więc wspomożemy się naszym jednolinijkowym programem i dokonamy ręcznej kategoryzacji obecnych w nim elementów.
W zapisie (print "Witaj, Lispie!"):
(…)jest S-wyrażeniem, bo jest symbolicznie zapisaną listą S-wyrażeń;printjest S-wyrażeniem, bo jest atomem;"Witaj, Lispie!"jest S-wyrażeniem, bo jest atomem.
Graficznie można ten zestaw przedstawić w następujący sposób:
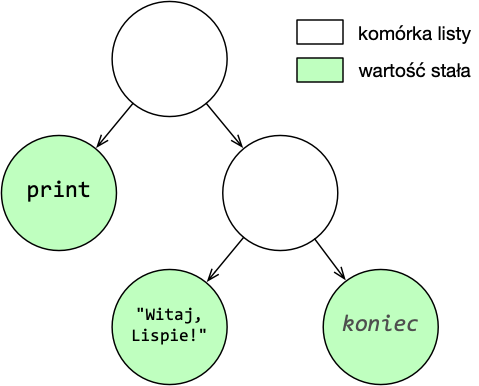
W odróżnieniu od innych Lispów złożone S-wyrażenia w Clojure budowane są nie tylko w oparciu o listy oznaczone nawiasami okrągłymi, ale również na bazie dodatkowych znaczników, które odpowiadają pewnym rodzajom kolekcji. Zależnie od użytego zapisu w pamięci powstanie struktura danych reprezentująca odpowiedni rodzaj S-wyrażenia:
| Notacja | Literał | S-wyrażenie | Struktura | Typ danych |
|---|---|---|---|---|
(a…z) |
listowy | listowe | lista | PersistentList |
[a…z] |
wektorowy | wektorowe | wektor | PersistentVector |
{a b … x y} |
mapowy | mapowe | mapa | PersistentArrayMapPersistentHashMap |
#{a…z} |
zbiorowy | zbiorowe | zbiór | PersistentHashSet |
Atomy
Omawiając symboliczne wyrażenia, wspomnieliśmy o ich specyficznej klasie zwanej atomami (ang. atoms). Atomem będzie taki element lispowej składni, który nie jest złożony (nie jest: listą, zbiorem, wektorem ani mapą). Wyjątki to pusta lista, pusty zbiór, pusty wektor i pusta mapa, które są zarówno wyrażeniami złożonymi, jak i atomami.
Do powyższej definicji należy jednak dodać jeszcze jeden istotny warunek, który decyduje o tym, że symboliczny zapis możemy uznać za lispowy atom. Przypomnijmy sobie nasz program:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
W poprzednich przykładach mogliśmy zauważyć, że print i Witaj, Lispie! są
atomami, ale czy byłyby nimi dowolne zestawy znaków, które nie są parą nawiasów
z zawartością? Nie. Atom musi być poprawną konstrukcją składniową, na podstawie
której czytnik będzie w stanie zdecydować, jaką wartość zwrócić. Istnieje tu
więc pewien rygor. W tym konkretnym przypadku napis print zostanie zapamiętany
w postaci symbolu, a Witaj, Lispie! w formie łańcucha znakowego, ponieważ spełniają
składniowe warunki reprezentacji konkretnych struktur danych.
Owszem, reguły syntaktyczne są na tyle liberalne, że większość przypadkowo wpisanych słów czy nawet pojedynczych znaków zostanie uznanych za symbole (a więc atomy), jednak umieszczenie w symbolicznej etykiecie nawiasu czy rozpoczęcie jej cyfrą będą poważnymi nadużyciami i czytnik przestanie z nami współpracować.
Warto zaznaczyć, że pojęcie atomu jako klasy wyrażeń składniowych nie jest spopularyzowane w środowisku programistów języka Clojure. Wynika to prawdopodobnie z faktu, że w języku tym funkcjonuje referencyjny typ danych o nazwie Atom, który pomaga w przeprowadzaniu współbieżnych operacji na danych.
Listowe S-wyrażenia
Najczęściej spotykaną klasą S-wyrażeń są listowe S-wyrażenia (ang. list S-expressions). To właśnie dzięki nim programy pisane w dialektach języka Lisp składają się z dużej liczby nawiasów.
Listowe S-wyrażenie w Clojure powinno być listą elementów (innych S-wyrażeń), które oddzielone są znakami spacji, przecinka lub oboma tymi znakami. Początek i koniec listowego S-wyrażenia powinien być oznaczony otwierającym i zamykającym nawiasem okrągłym.
Podczas wartościowania niepustej listy jej pierwszy element określa sposób obsługi
formy. Symbol na tej pozycji może nazywać formę specjalną, makro lub Var, którego
wartość jest wywoływalna; każde inne wyrażenie operatora jest wartościowane i także
musi dać IFn. W zwykłym wywołaniu funkcji pozostałe elementy są wartościowane od
lewej do prawej i przekazywane jako argumenty.
Jeżeli nie podamy żadnych elementów, listowe S-wyrażenie spowoduje wygenerowanie pustej listy.
 1;; wywołanie funkcji +
 2
 3(+ 1 2 3)
 4;=> 6
 5
 6;; wywołanie makra defn
 7;; służącego do definiowania funkcji nazwanej
 8
 9(defn powitaj [] "Witaj!")
10;=> #'user/powitaj
11
12;; wywołanie zdefiniowanej funkcji powitaj
13
14(powitaj)
15;=> "Witaj!"
16
17;; forma specjalna def
18;; służąca do definiowania zmiennej globalnej
19
20(def x 2)
21;=> #'user/x
22
23;; podwojenie wartości zmiennej globalnej
24;; identyfikowanej symbolem x
25
26(+ x x)
27;=> 4
28
29;; lista pusta
30
31()
32;=> ()
;; wywołanie funkcji +

(+ 1 2 3)
;=> 6

;; wywołanie makra defn
;; służącego do definiowania funkcji nazwanej

(defn powitaj [] "Witaj!")
;=> #'user/powitaj

;; wywołanie zdefiniowanej funkcji powitaj

(powitaj)
;=> "Witaj!"

;; forma specjalna def
;; służąca do definiowania zmiennej globalnej

(def x 2)
;=> #'user/x

;; podwojenie wartości zmiennej globalnej
;; identyfikowanej symbolem x

(+ x x)
;=> 4

;; lista pusta

()
;=> ()
Starsze dialekty Lispu obsługiwały nieco odmienną postać listowych S-wyrażeń. W parze
nawiasów nie umieszczano listy wszystkich elementów, ale tylko jedną jej komórkę
z podziałem na lewą i prawą wartość, które oddzielano znakiem kropki, a koniec listy
oznaczano symbolem nil, np.:
(+ . (1 . (2 . nil)))
(+ . (1 . (2 . nil)))
W Clojure ten rodzaj zapisu nie jest obsługiwany, chociaż istnieją struktury danych, które umożliwiają przeprowadzanie operacji na pojedynczych komórkach i tworzenie tzw. sekwencji.
Wektorowe S-wyrażenia
Literały wektorowe tworzą tzw. wektorowe S-wyrażenia, jednak w przeciwieństwie do wyrażeń listowych elementy umieszczane na ich pierwszych pozycjach nie mają specjalnego znaczenia. Efektem użycia wektorowego S-wyrażenia w podstawowej formie będzie struktura danych zwana wektorem, a każdy z elementów po uprzednim obliczeniu jego wartości stanie się jej składnikiem.
Z użyciem wektorowych S-wyrażeń możemy:
-
tworzyć wspomniane wyżej wektory i używać ich dla potrzeb logiki aplikacji,
-
określać listy argumentów definiowanych funkcji i makr,
-
wyrażać powiązania symboli z wartościami w odpowiednich konstrukcjach specjalnych (m.in.
letczybinding), -
dokonywać tzw. dekompozycji złożonych struktur o sekwencyjnym interfejsie dostępu.
;; wektor literalny

[1 2 3 4]
;=> [1 2 3 4]

;; wektor literalny

[(+ 1 1) 2 3 4]
;=> [1 2 3 4]

;; wektor powiązań w formie let
;; wytwarza leksykalne powiązanie symbolu a z wartością 1

(let [a 1] a)
;=> 1

;; wektorowa forma powiązaniowa w formie let (dekompozycja)
;; wewnątrz wektora powiązań formy let
;; dokonuje powiązania każdego symbolu z S-wyrażenia [a b]
;; z wartością inicjującą z S-wyrażenia [1 2]
;; zgodnie z pozycją występowania

(let [[a b] [1 2]]
  (+ a b))
;=> 3

;; lista argumentów w definicji funkcji nazwanej

(defn dodaj
  [a b]
  (+ a b))
(dodaj 2 2)
;=> 4

;; wektor pusty

[]
;=> []
;; wektor literalny

[1 2 3 4]
;=> [1 2 3 4]

;; wektor literalny

[(+ 1 1) 2 3 4]
;=> [1 2 3 4]

;; wektor powiązań w formie let
;; wytwarza leksykalne powiązanie symbolu a z wartością 1

(let [a 1] a)
;=> 1

;; wektorowa forma powiązaniowa w formie let (dekompozycja)
;; wewnątrz wektora powiązań formy let
;; dokonuje powiązania każdego symbolu z S-wyrażenia [a b]
;; z wartością inicjującą z S-wyrażenia [1 2]
;; zgodnie z pozycją występowania

(let [[a b] [1 2]]
  (+ a b))
;=> 3

;; lista argumentów w definicji funkcji nazwanej

(defn dodaj
  [a b]
  (+ a b))
(dodaj 2 2)
;=> 4

;; wektor pusty

[]
;=> []
Mapowe S-wyrażenia
Dzięki literałowi mapowemu możemy konstruować mapowe S-wyrażenia (ang. map S-expressions). W podstawowej formie pozwalają one wyrażać asocjacyjną strukturę danych zwaną mapą, która składa się ze zindeksowanych par typu klucz–wartość. Wartości powinny być oddzielone znakami spacji, znakami przecinka, albo obydwoma tymi znakami. Każdy pierwszy element w parze nazywamy kluczem (ang. key), a drugi wartością (ang. value).
Z użyciem mapowych S-wyrażeń możemy:
-
tworzyć wspomniane wyżej mapy i używać ich dla potrzeb logiki aplikacji,
-
określać listy argumentów nazwanych definiowanych funkcji i makr,
-
konstruować tzw. mapy metadanowe pozwalające wzbogacać niektóre konstrukcje w metadane, które mogą je opisywać bądź sterować ich właściwościami;
-
dokonywać dekompozycji złożonych struktur o asocjacyjnym interfejsie dostępu.
;; mapa literalna

{"a" 1 "b" 2}
;=> {"a" 1 "b" 2}

;; mapa wyrażająca argumenty nazwane
;; definiowanej funkcji
;; klucze a i b muszą być łańcuchami znakowymi

(defn dodaj [& {:strs [a b]}]
  (+ a b))

;; wywołanie funkcji z argumentami nazwanymi

(dodaj "b" 1, "a" 3)
;=> 4

;; mapa metadanowa definiowanej funkcji
;; z łańcuchem dokumentującym (klucz :doc)

(defn dodaj
  {:doc "Ta funkcja dodaje dwie liczby."}
  [a b]
  (+ a b))
;=> #'user/dodaj

;; wywołanie łańcucha dokumentującego dla dodaj
(doc dodaj)
;=>> -------------------------
;=>> user/dodaj
;=>> ([a b])
;=>>   Ta funkcja dodaje dwie liczby.
;=> nil

;; mapowa forma powiązaniowa w formie let (dekompozycja)
;; wewnątrz wektora powiązań formy let
;; dokonuje powiązania symboli a i b
;; z wartościami pochodzącymi z mapy o indeksach "a" i "b"

(let [{:strs [a b]} {"b" 1 "a" 3}]
  (+ a b))
;=> 4

;; mapa pusta

{}
;=> {}
;; mapa literalna

{"a" 1 "b" 2}
;=> {"a" 1 "b" 2}

;; mapa wyrażająca argumenty nazwane
;; definiowanej funkcji
;; klucze a i b muszą być łańcuchami znakowymi

(defn dodaj [& {:strs [a b]}]
  (+ a b))

;; wywołanie funkcji z argumentami nazwanymi

(dodaj "b" 1, "a" 3)
;=> 4

;; mapa metadanowa definiowanej funkcji
;; z łańcuchem dokumentującym (klucz :doc)

(defn dodaj
  {:doc "Ta funkcja dodaje dwie liczby."}
  [a b]
  (+ a b))
;=> #'user/dodaj

;; wywołanie łańcucha dokumentującego dla dodaj
(doc dodaj)
;=>> -------------------------
;=>> user/dodaj
;=>> ([a b])
;=>>   Ta funkcja dodaje dwie liczby.
;=> nil

;; mapowa forma powiązaniowa w formie let (dekompozycja)
;; wewnątrz wektora powiązań formy let
;; dokonuje powiązania symboli a i b
;; z wartościami pochodzącymi z mapy o indeksach "a" i "b"

(let [{:strs [a b]} {"b" 1 "a" 3}]
  (+ a b))
;=> 4

;; mapa pusta

{}
;=> {}
Zbiorowe S-wyrażenia
Literał zbiorowy umożliwia zapisywanie zbiorowych S-wyrażeń (ang. set S-expressions). Dzięki nim można w łatwy i przejrzysty sposób wyrażać zbiory, czyli struktury, w których każdy element występuje tylko raz.
Literał zbiorowy składa się z nawiasów klamrowych poprzedzonych znakiem kratki, wewnątrz których umieszczono niepowtarzalne w obrębie zbioru wartości. Elementy zbiorowego S-wyrażenia powinny być oddzielone znakiem spacji, przecinkiem lub obydwoma tymi znakami.
Jeżeli element wyrażenia zbiorowego nie jest wartością stałą, zostanie przeliczony zanim dojdzie do utworzenia obiektu reprezentującego zbiór.
#{1 2 3 4}
;=> #{1 2 3 4}

#{1 (+ 1 1) 3 4}
;=> #{1 2 3 4}

;; zbiór pusty

#{}
;=> #{}
#{1 2 3 4}
;=> #{1 2 3 4}

#{1 (+ 1 1) 3 4}
;=> #{1 2 3 4}

;; zbiór pusty

#{}
;=> #{}
Formy wytwarzane przez czytnik
Spójrzmy, co czytnik zwróci po wczytaniu naszego programu:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
Otwierający nawias wprowadza listę. Czytnik umieszcza na jej pierwszej pozycji
wartość Symbol o nazwie print, a na drugiej łańcuch Javy
"Witaj, Lispie!". Wynikiem są zatem zwykłe dane Clojure: lista zawierająca symbol
i łańcuch znakowy.
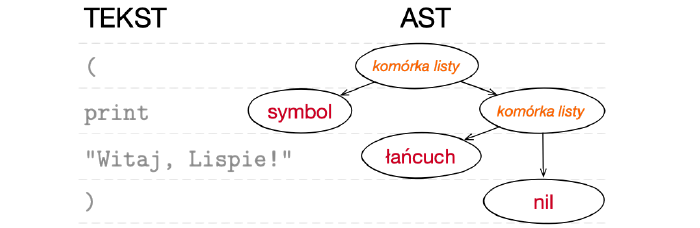
Listy wytworzonej przez czytnik nie należy mylić z wewnętrznym abstrakcyjnym
drzewem składniowym kompilatora. Kompilator analizuje listę w kontekście
leksykalnym i przestrzeni nazw, po czym może reprezentować rozpoznane wywołanie za
pomocą prywatnych danych implementacyjnych. Ta przeanalizowana reprezentacja nie jest
tym, co zwraca read, ani wartością przekazywaną do makra.
Homoikoniczność
Clojure nazywamy homoikonicznym, ponieważ programy są reprezentowane przez te
same rodzaje niemutowalnych struktur danych, na których rutynowo operują programy.
Odpowiedniość jest strukturalna, a nie tekstowa: komentarze, białe znaki, przecinki
i wiele zapisów makr czytnika nie jest zachowywanych. Przykładowo 'x i (quote x)
są wczytywane do równoważnych danych, choć mają odmienne sekwencje znaków.
Własność ta pozwala makrom składniowym przyjmować niewartościowane formy jako dane i zwracać formy zastępcze do dalszej analizy kompilatora. Nie wymaga udostępniania AST kompilatora ani modyfikowania już wykonywanego kodu maszynowego.
Semantyka
Kolejną warstwą jest wartościowanie (ang. evaluation): nadanie formie znaczenia w określonym kontekście leksykalnym i przestrzeni nazw oraz uzyskanie jej wartości. Clojure dla JVM nie ma osobnego interpretera tych form. Kompilator je analizuje, w razie potrzeby rozwija makra, emituje kod bajtowy i wykonuje ten kod; REPL jedynie sprawia, że cykl ten wydaje się natychmiastowy.
Przywołajmy raz jeszcze nasz przykład:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
Po wczytaniu kompilator otrzymuje jedną listę zawierającą symbol i łańcuch. Analizuje ją jako pojedynczą formę, aby uzyskać wartość najbardziej zewnętrznego wyrażenia.
W podanym przykładzie pierwszym elementem listy jest symbol print, który
identyfikuje wbudowaną funkcję języka Clojure służącą do wyświetlania tekstu na
ekranie. Badając powiązania leksykalne i odwzorowania bieżącej przestrzeni
nazw, kompilator rozpozna symbol jako Var clojure.core/print i ustali, że ma
do czynienia z wywołaniem funkcji. Podczas działania programu zostanie wywołana
wartość funkcyjna tego Vara.
Pozostałym elementem jest argument funkcji. Operandy zwykłego wywołania funkcji są
wartościowane od lewej do prawej. Łańcuch wartościuje się do siebie samego, więc do
print zostanie przekazana wynikowa wartość java.lang.String.
Uruchomienie podprogramu funkcji print sprawi, że powstanie zamierzony efekt
uboczny w postaci wyświetlenia na ekranie napisu:
Witaj, Lispie!
Dodatkowo funkcja zwróci wartość, która zależnie od sposobu uruchomienia programu będzie wyświetlona (w przypadku interaktywnej konsoli) lub pozostanie nieobsłużona (w innych przypadkach).
Formy
Forma (ang. form) jest wartością Clojure przedstawioną kompilatorowi do wartościowania. Listy są ważnymi formami, ale nie wszystkie formy są zagnieżdżonymi listami: wartościować można również symbole, literały, wektory, mapy i zbiory.
Znaczenie zależy zarówno od wartości, jak i kontekstu. Wartościowanie symbolu x
w (x 1) może dać funkcję, mapę, wektor, zbiór, klucz lub inny obiekt implementujący
clojure.lang.IFn. Lista jest wtedy zwykłym wywołaniem, a kontrakt obiektu
wywoływalnego określa znaczenie argumentu 1.
Zanim przejdziemy do omawiania głównych rodzajów form, nazwijmy te, które zostaną rozpoznane w naszym programie:
(print "Witaj, Lispie!")
(print "Witaj, Lispie!")
(…)– forma listowa,print– forma symbolowa,"Witaj, Lispie!"– forma samowartościująca,(print "Witaj, Lispie!")– forma wywołania funkcji:- po rozpoznaniu
printjako Vara, którego wartość jest wywoływalna; - po zwartościowaniu argumentu łańcuchowego.
- po rozpoznaniu
Formy samowartościujące
Łańcuchy, liczby, znaki, klucze, true, false i nil wartościują się do siebie
samych. Tak samo zachowują się zwykle inne obiekty, którym nie przypisano specjalnych
reguł wartościowania. Puste kolekcje są wartościami; niepuste formy wektorowe,
mapowe i zbiorowe wartościują najpierw swoje elementy.
"Witaj, Lispie!"  ; łańcuch tekstowy
\a                ; znak
()                ; lista pusta
123               ; liczba całkowita
:lalala           ; klucz
"Witaj, Lispie!"  ; łańcuch tekstowy
\a                ; znak
()                ; lista pusta
123               ; liczba całkowita
:lalala           ; klucz
Forma specjalna quote podlega innej regule: zwraca swój argument jako dane bez
wartościowania tego argumentu. Mechanizm cytowania zostanie dokładniej omówiony
w dalszej części.
Formy symbolowe
Symbol będzie przez ewaluator potraktowany jak forma symbolowa (ang. symbol form), który spróbuje odnaleźć powiązaną z nim wartość. Zależnie od kontekstu nazwa symbolu może być rozpoznawana w różnych miejscach, np. w powiązaniach leksykalnych albo przestrzeniach nazw i ich zmiennych globalnych. Rozpoznanie symbolu daje skojarzoną wartość; nie przepisuje w miejscu struktury danych wytworzonej przez czytnik.
print
+
print
+
Zobacz także:
- „Formy symbolowe”, rozdział IV.
Formy złożone
Wektory, mapy i zbiory są formami kolekcji. Wyrażenia ich elementów zostaną zwartościowane, a uzyskane wartości zebrane w wektorze, mapie bądź zbiorze. Lista podlega opisanym niżej regułom operatora, zamiast wartościować się jak zwykła kolekcja.
 [1 2 3]        ; forma wektorowa
#{1 2 3}        ; forma zbiorowa
 {"a" 1 "b" 2}  ; forma mapowa
'(1 2 3)        ; forma listowa (lista literalna)
 [1 2 3]        ; forma wektorowa
#{1 2 3}        ; forma zbiorowa
 {"a" 1 "b" 2}  ; forma mapowa
'(1 2 3)        ; forma listowa (lista literalna)
W przypadku niepustej listy lub sekwencji kompilator najpierw sprawdzi, czy
operator nazywa formę specjalną albo makro. W przeciwnym razie operator i argumenty
zostaną zwartościowane od lewej do prawej, a wartość operatora wywołana jako IFn.
Formy przeszukiwania
Wektory, zbiory i mapy implementują IFn, mogą więc
zajmować pozycję operatora. Wektor wyszukuje indeks, zbiór — element, a mapa — klucz.
Wywołania mapy przyjmują również drugi argument: wartość zwracaną, gdy klucza nie
znaleziono. Dopuszczalne liczby argumentów należą do kontraktu wywołania danego typu.
([1 2 3]         0)  ;=> 1
(#{1 2 3}        2)  ;=> 2
({"a" 1 "b" 2} "b")  ;=> 2
([1 2 3]         0)  ;=> 1
(#{1 2 3}        2)  ;=> 2
({"a" 1 "b" 2} "b")  ;=> 2
Słowa kluczowe i symbole literalne również implementują IFn i mogą
wyszukiwać siebie w kolekcji asocjacyjnej. Przyjmują kolekcję albo kolekcję wraz
z wartością zwracaną, gdy elementu nie znaleziono.
(:a {:a 1 :b 2})       ;=> 1
(:a #{:a :b :c})       ;=> :a
('a {'a 1 'b 2 :c 3})  ;=> 1
(:a {:a 1 :b 2})       ;=> 1
(:a #{:a :b :c})       ;=> :a
('a {'a 1 'b 2 :c 3})  ;=> 1
Formy wywołania funkcji
Jeżeli zwartościowany operator będzie obiektem funkcyjnym, obliczone wartości
argumentów zostaną przekazane do jego metody invoke. Mechanizm współpracy z Javą
korzysta z form wyrażeń hosta rozpoznawanych przez kompilator; same metody Javy nie
są obiektami funkcyjnymi Clojure.
(print "Witaj, Lispie!")  ;=> nil =>> Witaj, Lispie!
(+ 2 2)                   ;=> 4
(.toLowerCase "A")        ;=> a
(print "Witaj, Lispie!")  ;=> nil =>> Witaj, Lispie!
(+ 2 2)                   ;=> 4
(.toLowerCase "A")        ;=> a
Formy specjalne
Jeżeli pierwszy symbol nazywa formę specjalną (ang. special form), kompilator zastosuje właściwą jej gramatykę i reguły wartościowania. Formy specjalne są rozpoznawane bezpośrednio przez kompilator; nie są Varami zawierającymi funkcje.
(def   x 1)                           ; definiowanie zmiennej globalnej
(fn    [x] (inc x))                   ; tworzenie funkcji
(def   f (fn [x] (inc x)))            ; definiowanie funkcji nazwanej
(let   [a 1] a)                       ; tworzenie powiązań leksykalnych
(quote (1 2 3))                       ; cytowanie
(. System (getProperty "user.home"))  ; dostęp do klas Javy
(def   x 1)                           ; definiowanie zmiennej globalnej
(fn    [x] (inc x))                   ; tworzenie funkcji
(def   f (fn [x] (inc x)))            ; definiowanie funkcji nazwanej
(let   [a 1] a)                       ; tworzenie powiązań leksykalnych
(quote (1 2 3))                       ; cytowanie
(. System (getProperty "user.home"))  ; dostęp do klas Javy
Formy specjalne są – jak sama nazwa mówi – formami, których reguły różnią się od reguł zwykłych wywołań funkcji. Jedne wprowadzają powiązania, inne sterują wartościowaniem, jeszcze inne współpracują z platformą hosta. Ich argumenty są przetwarzane dokładnie tak, jak określa to dana forma specjalna.
Dzięki formom specjalnym możemy na przykład definiować zmienne globalne czy funkcje, a także tworzyć powiązania symboli z wartościami w pewnych obszarach programu.
Zagnieżdżone wartościowanie
Wartościowanie podlega regule właściwej danej formie. Zwykłe wywołania wartościują operator i argumenty, formy kolekcji — swoje elementy, a formy specjalne i makra określają własne zachowanie. Wartość zwrócona przez jedną z tych operacji jest wynikiem, a nie automatycznie kolejną formą do wartościowania. W szczególności rozpoznanie symbolu powiązanego z listą zwraca tę listę jako wartość, zamiast ją wykonywać.
Niepoprawne formy
Jeżeli forma narusza właściwą jej regułę — na przykład operator nie implementuje
IFn, symbolu nie można rozpoznać albo argumenty mają niezgodne typy — wartościowanie
rzuci wyjątek. To, czy otaczający proces zakończy pracę, zależy od sposobu obsługi
błędów; REPL zwykle zgłasza błąd i działa dalej.
1(1 2 3)   ; liczba 1 nie jest wywoływalna
2(())      ; lista pusta nie jest wywoływalna
3(+ /)     ; + nie może dodać wartości funkcyjnej przechowywanej przez /
4(nie_ma)  ; brak konstrukcji identyfikowanej symbolem nie_ma
5nie_ma    ; brak konstrukcji identyfikowanej symbolem nie_ma
(1 2 3)   ; liczba 1 nie jest wywoływalna
(())      ; lista pusta nie jest wywoływalna
(+ /)     ; + nie może dodać wartości funkcyjnej przechowywanej przez /
(nie_ma)  ; brak konstrukcji identyfikowanej symbolem nie_ma
nie_ma    ; brak konstrukcji identyfikowanej symbolem nie_ma
Nazwy niektórych form są umowne, tzn. bazują na założeniu, że pewne S-wyrażenia dadzą się przeliczyć do danych konkretnych typów. Na przykład zapis:
(dodaj 1 2 3)
(dodaj 1 2 3)
nazwiemy umownie formą wywołania funkcji, chociaż w istocie nie mamy pewności, czy
forma symbolowa dodaj będzie rozpoznana w przestrzeni nazw jako zmienna globalna,
a znajdujący się tam obiekt referencyjny będzie zawierał odniesienie do funkcji.
Formy powiązaniowe
Forma powiązaniowa (ang. binding form) to konstrukcja, w której do symbolicznego identyfikatora przypisywana jest wartość, aby wytworzyć powiązanie. Na poziomie składniowym będziemy w tych formach mieli do czynienia z niezacytowanymi symbolami, jednak nie będą one traktowane jak formy symbolowe, których wartości należy poznać, lecz właśnie jako wyrażenia przypisujące pamięciowe obiekty do symbolicznych nazw.
Formę powiązaniową rozpoznamy w wyrażeniach reprezentujących pewne formy specjalne, gdzie będziemy mieli do czynienia z:
-
parą złożoną z niezacytowanego symbolu i innej formy (reprezentującej wartość, która po obliczeniu ma być przypisana);
-
niezacytowanego symbolu występującego samodzielnie, np. w wektorze parametrycznym funkcji, gdzie wartość będzie dynamicznie przypisana podczas przekazywania argumentów przy jej wywołaniu.
Formy powiązaniowe symboli są składnikiem niektórych form złożonych i specjalnych. Znajdziemy je na przykład:
-
w argumencie określającym nazwę:
-
- formy specjalnej
leti podobnych, - formy specjalnej
loopi podobnych, - makra
with-local-vars, - makra
binding;
- formy specjalnej
-
w argumencie określającym nazwę i/lub wektorze parametrycznym:
Dodatkowo formy powiązaniowe mogą pojawić się również w tzw. powiązaniach strukturalnych, czyli abstrakcyjnych powiązaniach, w których dochodzi do dekompozycji złożonych struktur danych i przypisania symbolom wartości na wskazanych pozycjach lub identyfikowanych podanymi kluczami. Będziemy mieli wtedy do czynienia z powiązaniową formą wektora (ang. vector binding form) lub powiązaniową formą mapy (ang. map binding form), w której zamiast pojedynczego, niezacytowanego symbolu po lewej stronie pojawia się wektorowe bądź mapowe S-wyrażenie.
Niektóre inne konstrukcje korzystające z form powiązaniowych możemy również
intuicyjnie określać mianem form powiązaniowych. Będą to takie wyrażenia, których
celem jest przede wszystkim wykształcanie powiązań. Na przykład formę
specjalną let nazwiemy też formą powiązaniową let (ang. let binding form),
mimo że w istocie korzysta ona z potencjalnie wielu podstawowych form powiązaniowych
zgrupowanych w wektorze powiązań.
(def x 5)     ; symbol x w formie powiązaniowej
(fn [x] nil)  ; symbol x formie powiązaniowej
(let [x 2])   ; symbol x w formie powiązaniowej

(defn nazwa   ; symbol nazwa w formie powiązaniowej (nazwa funkcji)
  [x]         ; symbol x w formie powiązaniowej (nazwa parametru)
  nil)
(def x 5)     ; symbol x w formie powiązaniowej
(fn [x] nil)  ; symbol x formie powiązaniowej
(let [x 2])   ; symbol x w formie powiązaniowej

(defn nazwa   ; symbol nazwa w formie powiązaniowej (nazwa funkcji)
  [x]         ; symbol x w formie powiązaniowej (nazwa parametru)
  nil)
Parametry funkcji ustanawiają powiązania leksykalne podczas jej wywołania. Są
czymś innym niż dynamiczne powiązania Varów tworzone przez binding.
Zobacz także:
- „Powiązania”;
- „Formy powiązaniowe symboli”, rozdział IV;
- „Powiązania i przestrzenie nazw”, rozdział VI.
Cytowanie
Ważną konstrukcją specjalną w Clojure i innych Lispach jest forma specjalna quote,
która zwraca swój argument bez wartościowania tego argumentu. Czytnik nadal
wytwarza kompletną wartość argumentu. Podczas analizy kompilatora quote nakazuje
zwrócić tę wartość jako dane, zamiast rozpoznawać jej symbole lub wywoływać listy.
W dialektach Lispu użycie formy quote pozwala stwarzać literalne warianty
struktur, które w postaciach niezacytowanych byłyby użyte do reprezentowania kodu
źródłowego programu i/lub wartościowane.
quote
1(quote raz)        ; literalny symbol
2(quote (1 2 3))    ; literalna lista
3(quote [a b])      ; literalny wektor
4(quote {a 1 b 2})  ; literalna mapa
5(quote #{1 2 3})   ; literalny zbiór
(quote raz)        ; literalny symbol
(quote (1 2 3))    ; literalna lista
(quote [a b])      ; literalny wektor
(quote {a 1 b 2})  ; literalna mapa
(quote #{1 2 3})   ; literalny zbiór
Powyższe można zapisać także posługując się lukrem składniowym:
'raz
'(1 2 3)
'[a b]
'{a 1 b 2}
'#{a b}
Te same struktury danych moglibyśmy wytworzyć nie stosując cytowania, ale korzystając z odpowiednich, wbudowanych funkcji języka:
1(symbol "raz")                            ; symbol
2(list 1 2 3)                              ; lista
3(vector (symbol "a") (symbol "b"))        ; wektor
4(hash-map (symbol "a") 1 (symbol "b") 2)  ; mapa
5(hash-set 1 2 3)                          ; zbiór
(symbol "raz")                            ; symbol
(list 1 2 3)                              ; lista
(vector (symbol "a") (symbol "b"))        ; wektor
(hash-map (symbol "a") 1 (symbol "b") 2)  ; mapa
(hash-set 1 2 3)                          ; zbiór
Działanie obejmuje całą cytowaną wartość: zagnieżdżone symbole i listy również pozostają danymi.
1(quote (a b c))        ; lista z literalnymi symbolami
2(quote (+ 2 (* 2 3)))  ; lista z literalnymi symbolami i liczbami
3(quote [raz 2 3])      ; wektor z literalnym symbolem i liczbami
4(quote {a 1 b 2})      ; mapa z literalnymi symbolami i liczbami
5(quote #{a b c})       ; zbiór z literalnymi symbolami
(quote (a b c))        ; lista z literalnymi symbolami
(quote (+ 2 (* 2 3)))  ; lista z literalnymi symbolami i liczbami
(quote [raz 2 3])      ; wektor z literalnym symbolem i liczbami
(quote {a 1 b 2})      ; mapa z literalnymi symbolami i liczbami
(quote #{a b c})       ; zbiór z literalnymi symbolami
Terminy literalny wektor, literalna mapa i literalny zbiór opisują zapis
czytelnika, a nie gwarantują sposobu wartościowania każdej zagnieżdżonej formy. Gdy
niezacytowana forma kolekcji jest wartościowana, wartościowane są jej elementy.
Cytowanie kolekcji zewnętrznej zapobiega temu, ponieważ cały argument quote
zostaje zwrócony jako dane.
[1 2 3]         ; literalny wektor; jego elementy wartościują się do siebie
[1 2 (inc 2)]   ; literalny wektor wartościowany do [1 2 3]
'[1 2 (inc 2)]  ; quote zwraca wektor zawierający listę (inc 2)
'[1 2]          ; cytowanie nie daje tutaj obserwowalnej różnicy
[1 2 3]         ; literalny wektor; jego elementy wartościują się do siebie
[1 2 (inc 2)]   ; literalny wektor wartościowany do [1 2 3]
'[1 2 (inc 2)]  ; quote zwraca wektor zawierający listę (inc 2)
'[1 2]          ; cytowanie nie daje tutaj obserwowalnej różnicy
Spróbujmy jeszcze zastosować cytowanie w odniesieniu do naszego szablonowego programu:
'(print "Witaj, Lispie!")
'(print "Witaj, Lispie!")
Efekt wartościowania powyższego wyrażenia to wartość, którą jest lista zawierająca symbol i łańcuch znakowy, czyli nasz pierwotny program, dający wyrazić się tekstem:
(print "Witaj, Lispie!")
Cytowanie wartości samowartościującej, takiej jak łańcuch, daje tę samą wartość. Skutek cytowania jest najlepiej widoczny dla symboli i list, których zwykłe reguły wartościowania są inne.
Identyfikatory
Identyfikatory (ang. identifiers) to konstrukcje, które pozwalają nazywać tożsamości (np. pojedyncze wartości czy złożone struktury danych umieszczane w pamięci), aby można się było do nich potem odwoływać.
W Clojure istnieją konstrukcje identyfikacyjne (omawiane niżej symbole), które mają specjalne znaczenie składniowe i nazywane przez nie obiekty są rozpoznawane automatycznie. Znajdziemy też takie (np. klucze), które posłużą nam do identyfikacji danych użytkowych, ale nie ma obowiązku ich używać.
Symbole
Symbol (ang. symbol) w Clojure to typ danych (ang. data type)
używany w formach jako nazwa, a w aplikacjach — jako dane symboliczne. Czytnik
wytwarza jedynie wartości typu Symbol; kompilator i konstrukcje powiązaniowe nadają
im zależne od kontekstu role nazw lokalnych, Varów, klas lub form specjalnych.
W Clojure formy symbolowe można wyrażać w tekście programu bez stosowania żadnych dodatkowych oznaczeń. Gdy symbol jest wartościowany jako forma, zostaje rozpoznany w bieżącym kontekście leksykalnym, przestrzeni nazw i hosta; nie jest samowartościujący.
Zapis symboli dopuszcza litery, cyfry i kilka znaków interpunkcyjnych, ze specjalnymi
regułami dotyczącymi początkowych cyfr, /, ., : oraz zastrzeżonego symbolu &.
Ponieważ ścisła gramatyka jest bogatsza niż krótka lista znaków, przy nietypowych
nazwach bezpieczniej oprzeć się na oficjalnej dokumentacji
czytnika.
1funk                ; funk to forma symbolowa
2(funk 1 2 3)        ; funk to forma symbolowa w formie wywołania funkcji
3(fn [x y] x)        ; symbole x oraz y są parametrami anonimowej funkcji
4                    ; [x y] zawiera dwie formy powiązaniowe symboli
5(.toLowerCase "A")  ; toLowerCase jest metodą klasy Javy
6
7; ChunkedSeq to klasa wewnętrzna klasy PersistentVector
8(new clojure.lang.PersistentVector$ChunkedSeq [1 2 3 4 5] 0 3)
funk                ; funk to forma symbolowa
(funk 1 2 3)        ; funk to forma symbolowa w formie wywołania funkcji
(fn [x y] x)        ; symbole x oraz y są parametrami anonimowej funkcji
                    ; [x y] zawiera dwie formy powiązaniowe symboli
(.toLowerCase "A")  ; toLowerCase jest metodą klasy Javy

; ChunkedSeq to klasa wewnętrzna klasy PersistentVector
(new clojure.lang.PersistentVector$ChunkedSeq [1 2 3 4 5] 0 3)
W wielu Lispach symbol jest typem referencyjnym, to znaczy samodzielnie identyfikuje inny obiekt, przechowując odwołanie do jego pamięciowej struktury. W przypadku Clojure jest inaczej – symbol nie zawiera żadnego odwołania, a to, że używając symbolowych form można wywoływać funkcje bądź odnosić się do stałych wartości zawdzięczamy odpowiedniemu traktowaniu przez ewaluator i przeszukiwaniu dodatkowych struktur (np. przestrzeni nazw czy obszaru powiązań leksykalnych).
Kropki mogą występować w nazwach przestrzeni i kwalifikowanych nazwach klas Javy. Kropka na początku albo końcu symbolu jest zastrzeżona dla składni współpracy Clojure z Javą.
Symbole z przestrzeniami
Symbol może opcjonalnie zawierać dodatkową nazwę określającą tzw. przestrzeń nazw, czyli specjalny zbiór, który służy do grupowania identyfikatorów w celu eliminowania konfliktów. Więcej szczegółów o korzystaniu z tego mechanizmu sterowania widocznością można znaleźć w dalszej części tego odcinka.
Nazwa przestrzeni jest łańcuchem znakowym podlegającym takiemu samemu rygorowi
syntaktycznemu, jak nazwa symbolu, a wyrażamy ją przez umieszczenie przed nazwą
symbolu i oddzielenie znakiem ukośnika (/), na przykład:
1my/funk        ; symbol funk z przestrzenią my
2(my/funk 1 2)  ; symbol funk z przestrzenią my w formie wywołania funkcji
my/funk        ; symbol funk z przestrzenią my
(my/funk 1 2)  ; symbol funk z przestrzenią my w formie wywołania funkcji
W obiekcie symbolu nie znajdziemy innego niż tekstowe odwołania do przestrzeni. Tu również nie dochodzi do przechowywania referencji. Możemy podać nieistniejącą przestrzeń i nie będzie to błąd, dopóki ewaluator nie zacznie wartościować zapisu.
Symbole literalne
Symbole znajdziemy w formach wytworzonych przez czytnik, gdzie analiza kompilatora może traktować je jako identyfikatory. Możemy też korzystać z cytowanych symboli jak ze zwykłych wartości w logice aplikacji. Będą wtedy na przykład pełniły funkcję prostych typów wyliczeniowych (ang. enumerated types), reprezentując stałe wartości wchodzące w skład ustalonych zbiorów:
1(list (symbol "trochę") (symbol "bardzo") (symbol "najbardziej"))
2(list 'trochę 'bardzo 'najbardziej)
3'(trochę bardzo najbardziej)
(list (symbol "trochę") (symbol "bardzo") (symbol "najbardziej"))
(list 'trochę 'bardzo 'najbardziej)
'(trochę bardzo najbardziej)
Powyższe trzy zapisy są równoważne. Pierwszy konstruuje literalną listę, której
elementami są symbole tworzone na bazie łańcuchów znakowych z użyciem wbudowanej
funkcji symbol; drugi również spowoduje powstanie listy, ale do wyrażania
literalnych symboli korzystamy z cytowania; trzeci natomiast czyni użytek
z rekurencyjnego cytowania całego listowego S-wyrażenia.
Cytowane symbole mogą też zawierać określenie przestrzeni nazw:
(symbol "nazwa" "przestrzeń")
'nazwa/przestrzeń
Czasami w Lispach używa się literalnych symboli jako kluczy indeksujących w strukturach asocjacyjnych (np. mapach):
{ 'trochę 21, 'bardzo 108, 'najbardziej 11 }
{ 'trochę 21, 'bardzo 108, 'najbardziej 11 }
Symbole nie muszą być internalizowane, ale równe symbole mają spójną semantykę równości i haszowania, są więc pełnoprawnymi kluczami map. Słowa kluczowe są bardziej idiomatyczne w wielu schematach danych aplikacyjnych, ponieważ wartościują się do siebie i zwyczajowo pełnią rolę kluczy asocjacyjnych — nie dlatego, że wyszukiwanie symboli byłoby semantycznie niebezpieczne.
Zobacz także:
- „Symbole”, rozdział IV.
Klucze
Słowo kluczowe (ang. keyword), zwane potocznie kluczem (ang. key) to typ
danych, który – podobnie jak symbole – służy do identyfikowania innych
obiektów, jednak w Clojure nie ma specjalnego znaczenia składniowego i klucze nie
identyfikują automatycznie innych konstruktów programu. Klucze wyrażane są obiektami
typu clojure.lang.Keyword.
Implementacja Clojure dla JVM internalizuje słowa kluczowe. Ich publicznym kontraktem pozostaje jednak tożsamość wartości i równość; kod aplikacji nie musi zależeć od konkretnej strategii alokacji.
Słowa kluczowe sprawdzają się w roli prostych typów wyliczeniowych lub indeksów w asocjacyjnych strukturach danych (np. mapach). Jeżeli chodzi o wbudowane mechanizmy języka Clojure, ze słowami kluczowymi spotkamy się m.in. w niektórych makrach i konstrukcjach wyrażających powiązania argumentów nazwanych funkcji.
Ze składniowego punktu widzeni każdy klucz ma nazwę, która musi być łańcuchem znakowym
rozpoczynającym się dwukropkiem (:) i mogącym zawierać znaki alfanumeryczne oraz:
*, +, !, -, _ i ?. W praktyce możemy korzystać z nieco bogatszego zestawu
znaków (np. coraz częstsze jest wykorzystywanie kropki dla oznaczenia wewnętrznych
hierarchii w niektórych bibliotekach), jednak może to ulec zmianie w przyszłości,
dlatego warto używać nazw kluczy zgodnych z dokumentacją języka.
Klucze są również funkcjami. Gdy umieścimy słowo kluczowe na pierwszym miejscu listowego S-wyrażenia, wywołany zostanie podprogram, który spróbuje odszukać indeks w asocjacyjnej lub zbiorowej kolekcji podanej jako argument.
Podobnie jak symbole, klucze mogą opcjonalnie zawierać określenie przestrzeni nazw.
:klucz                              ; klucz
::klucz                             ; klucz z bieżącą przestrzenią nazw
:przestrzeń/klucz                   ; klucz z przestrzenią
::klucz                             ; klucz w bieżącej przestrzeni nazw
(keyword "klucz")                   ; klucz z łańcucha znakowego
(keyword "przestrzeń" "klucz")      ; jw. lecz z określeniem przestrzeni
{:a 1 :b 2}                         ; mapa z indeksami w postaci kluczy
(defn x [& {:keys [kolor]}] kolor)  ; funkcja z argumentem nazwanym, kluczowym
(x :kolor 123)                      ; wywołanie funkcji z argumentem kluczowym
(:a {:a 1 :b 2})                    ; klucz jako funkcja przeszukująca mapę
(:a #{:a :b :c :d})                 ; klucz jako funkcja przeszukująca zbiór
:klucz                              ; klucz
::klucz                             ; klucz z bieżącą przestrzenią nazw
:przestrzeń/klucz                   ; klucz z przestrzenią
::klucz                             ; klucz w bieżącej przestrzeni nazw
(keyword "klucz")                   ; klucz z łańcucha znakowego
(keyword "przestrzeń" "klucz")      ; jw. lecz z określeniem przestrzeni
{:a 1 :b 2}                         ; mapa z indeksami w postaci kluczy
(defn x [& {:keys [kolor]}] kolor)  ; funkcja z argumentem nazwanym, kluczowym
(x :kolor 123)                      ; wywołanie funkcji z argumentem kluczowym
(:a {:a 1 :b 2})                    ; klucz jako funkcja przeszukująca mapę
(:a #{:a :b :c :d})                 ; klucz jako funkcja przeszukująca zbiór
Zobacz także:
- „Klucze”, rozdział IV.
Przestrzenie nazw
W języku Clojure korzysta się z konstruktu zwanego przestrzenią nazw (ang. namespace). W technologii informacyjnej terminem tym określa się mechanizm sterowania widocznością identyfikatorów, który pozwala na ich hierarchiczne grupowanie w celu unikania konfliktów. Popularnymi przykładami przestrzeni nazw mogą być struktury katalogowe systemów plikowych, rekordy DNS czy publiczne adresy IP.
Przestrzenie nazw w programowaniu komputerów pomagają oddzielać od siebie zbiory identyfikatorów używane w różnych komponentach (np. bibliotekach programistycznych) lub kontekstach, dzięki czemu udostępniane nazwy (np. modułów, klas, zmiennych czy funkcji) są unikatowe. Możemy wtedy korzystać w programie z kilku bibliotek, w których zdefiniowano tak samo nazwaną funkcję. Podczas odwoływania się do niej wymagane będzie użycie tzw. nazwy w pełni kwalifikowanej (ang. fully qualified name), zwanej też nazwą jednoznaczną, czyli identyfikatora wzbogaconego o określenie nazwy przestrzeni.
W Clojure przestrzeń nazw jest globalnie zarejestrowanym obiektem typu
clojure.lang.Namespace. Utrzymuje odwzorowania, których kluczami są symbole,
a wartościami Vary albo zaimportowane klasy Javy. Można ją oglądać jak tablicę
symboli, lecz nie jest zwykłą wartością mapy trwałej.
Ponieważ umieszczane w programie symbole mogą opcjonalnie zawierać określenie
przestrzeni nazw, więc możliwe jest z ich użyciem odwoływanie się do identyfikatorów
z różnych przestrzeni. Jeżeli symbol nie zawiera nazwy jednoznacznej, wtedy podczas jego
wartościowania przyjmuje się, że identyfikuje on konstrukcję zdefiniowaną w aktualnej
przestrzeni, wskazywanej przez dynamiczną zmienną globalną
clojure.core/*ns*:
;; symbol set/select kwalifikowany aliasem przestrzeni clojure.set
;; identyfikuje funkcję

(require '[clojure.set :as set])
(set/select odd? #{1 2 3 4})
;=> #{1 3}

;; symbol + z przestrzeni clojure.core
;; zaimportowanej do bieżącej (user)
;; identyfikuje funkcję

(+ 2 2)
;=> 4
;; symbol set/select kwalifikowany aliasem przestrzeni clojure.set
;; identyfikuje funkcję

(require '[clojure.set :as set])
(set/select odd? #{1 2 3 4})
;=> #{1 3}

;; symbol + z przestrzeni clojure.core
;; zaimportowanej do bieżącej (user)
;; identyfikuje funkcję

(+ 2 2)
;=> 4
Pierwsze wywołanie korzysta z symbolu set/select. Jego część przestrzeni nazw jest
lokalnym aliasem set, który analiza kompilatora rozpoznaje jako clojure.set;
odwzorowanie symbolu select w tej przestrzeni prowadzi do Vara zawierającego
funkcję. Argumenty odd? i #{1 2 3 4} zostaną następnie zwartościowane i przekazane
tej funkcji.
Drugi symbol nie ma części przestrzeni nazw. W przestrzeni user symbol + jest
rozpoznawany przez odniesienie do Vara clojure.core/+. Odniesienie zachowuje
tożsamość tego samego Vara; nie kopiuje wartości funkcji do user.
Zobacz także:
- „Powiązania i przestrzenie nazw”, rozdział VI.
Obsługa globalnych stanów
Opowiadając o Clojure, podkreśla się, że nie ma tam konwencjonalnych zmiennych, a struktury danych są niemutowalne. Dlaczego więc raz po raz przewija się określenie „zmienna globalna”?
Wiele aplikacji musi obsługiwać zmieniający się stan, którego część bywa współdzielona albo globalnie osiągalna pod stałymi nazwami. Przykładami mogą być: kondycja postaci w grze, układ okien interfejsu użytkownika bądź aktualnie przetwarzana zawartość wczytywanego pliku.
Do reprezentowania opisanych wyżej danych można by użyć konwencjonalnych zmiennych, czyli ustalonych przestrzeni pamięciowych o określonych nazwach, których zawartości są modyfikowane przez odpowiednie podprogramy (np. zmieniający punktację, reagujący na działania użytkownika odnośnie elementów interfejsu czy odczytujący dane z bazy). Jednak w takim modelu nie będziemy mogli posłużyć się wieloma wątkami bez stosowania dodatkowych mechanizmów izolacji. Pamięciowa szufladka zmiennej, reprezentująca ważny parametr, może zostać zreorganizowana przez jeden wątek, podczas gdy drugi będzie jeszcze przeprowadzał z jej użyciem ważną operację. Oznacza to więcej pracy dla programisty, który zamiast skupiać się na logice biznesowej aplikacji, musi pamiętać o zabezpieczaniu programu przed nim samym i wprowadzać semafory, blokady itp.
Clojure oddziela niemutowalne wartości od tożsamości, które mogą z czasem otrzymywać nowe wartości. Lokalne powiązania leksykalne są niemutowalne, natomiast Vary, Atomy, Refy i Agenty oferują różne kontrakty typów referencyjnych dla koordynowanej zmiany. Nie oznacza to zakazu mutacji wewnątrz JVM, lecz projekt, w którym dozwolone miejsca i reguły aktualizacji są jawne.
Aktualizacja referencji zmienia jej logiczną wartość bieżącą zgodnie z regułami koordynacji danego typu. Nowa wartość bywa trwałą kolekcją współdzielącą strukturę ze starą, ale ani odrębny adres pamięci, ani zachowana historia nie należą do ogólnego kontraktu referencji.
Typ Var
Var jest nazwaną referencją używaną przez globalne środowisko Clojure.
Może mieć powiązanie główne, współdzielone przez wątki bez powiązania lokalnego.
Vary oznaczone ^:dynamic można przepowiązywać za pomocą binding w bieżącym wątku
i dynamicznie zagnieżdżonych wywołaniach; zwykłe Vary nie uzyskują izolacji
poszczególnych wątków tylko dlatego, że są Varami.
Zwyczajowo obiekty typu Var są w Clojure internalizowane w przestrzeniach nazw,
tzn. nie istnieje powszechnie używana forma specjalna czy funkcja, która pozwalałaby
tworzyć je bez powiązania z jakimiś symbolicznymi identyfikatorami. Jest jednak makro
with-local-vars, które tworzy obiekty Var w zasięgu leksykalnym – muszą być one
wtedy identyfikowane podanymi symbolami widocznymi w wyrażeniu podanym jako
argument. Wskazywane w ten sposób wartości możemy odczytywać z użyciem funkcji
deref lub literału dereferencyjnego (umieszczanego przed symbolem znaku małpki):
(with-local-vars [a 5] @a)
;=> 5
(with-local-vars [a 5] @a)
;=> 5
Zobacz także:
- „Typ Var”, rozdział VII.
Zmienne globalne
Obiekty typu Var (a dokładniej clojure.lang.Var) są wraz z symbolami
wykorzystywane w Clojure do tworzenia zmiennych globalnych (ang. global
variables). Zmienne globalne służą do identyfikowania rzadko zmieniających się
tożsamości, np. wartości konfiguracyjnych czy zdefiniowanych w programie
funkcji.
Działa to tak, że przestrzeń nazw odwzorowuje symboliczną nazwę na konkretny Var.
Var udostępnia z kolei swoje bieżące powiązanie wątku, jeżeli takie istnieje,
a w przeciwnym razie — powiązanie główne. Odwzorowanie przestrzeni nazw ma więc
postać symbol → Var, a nie symbol → bieżąca wartość główna.
Spójrzmy na diagram ilustrujący sposób uzyskiwania obiektu funkcyjnego na podstawie jego nazwy w naszym przykładowym programie:
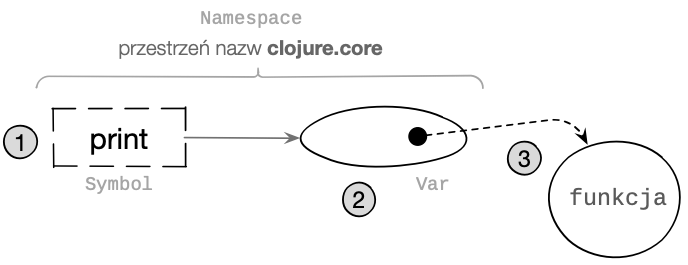
Analiza kompilatora i wykonanie przeprowadziły tu trzy pojęciowo odrębne kroki, aby dotrzeć do wywoływanej funkcji:
-
Symbol
printzostał rozpoznany przez odniesienie bieżącej przestrzeni nazw do Varaclojure.core/print. -
Podczas działania programu pobrane zostało bieżące powiązanie Vara — powiązanie wątku, gdy istnieje, w przeciwnym razie powiązanie główne.
-
Powiązanie zawierało obiekt funkcyjny, który został wywołany ze zwartościowanymi argumentami.
Tworzenie zmiennych globalnych możliwe jest z użyciem formy specjalnej def:
 1(def x 8)                ; x wskazuje na wartość 8
 2(def y [1 2 3])          ; y wskazuje na wektor [1 2 3]
 3(def pisz print)         ; pisz wskazuje na wartość bieżącą zmiennej print
 4(declare potem)          ; tworzy zmienną globalną bez powiązania z wartością
 5
 6(pisz x)                 ;=> 8
 7(pisz y)                 ;=> [1 2 3]
 8(pisz "Witaj, Lispie!")  ;=> Witaj, Lispie!
 9
10potem
11;=> #object[clojure.lang.Var$Unbound 0x53245a5b "Unbound: #'user/potem"]
(def x 8)                ; x wskazuje na wartość 8
(def y [1 2 3])          ; y wskazuje na wektor [1 2 3]
(def pisz print)         ; pisz wskazuje na wartość bieżącą zmiennej print
(declare potem)          ; tworzy zmienną globalną bez powiązania z wartością

(pisz x)                 ;=> 8
(pisz y)                 ;=> [1 2 3]
(pisz "Witaj, Lispie!")  ;=> Witaj, Lispie!

potem
;=> #object[clojure.lang.Var$Unbound 0x53245a5b "Unbound: #'user/potem"]
Zobacz także:
- „Powiązania i przestrzenie nazw”, rozdział VI;
- „Zmienne globalne”, rozdział VI.
Powiązania
Powiązanie (ang. binding) to w ujęciu ogólnym skojarzenie identyfikatora z identyfikowanym obiektem. Używając tego terminu, unikamy nieporozumień związanych z subtelnymi, ale istotnymi z punktu widzenia programisty różnicami w odwoływaniu się do obiektów z użyciem nazw.
W językach zakorzenionych imperatywnie często korzystamy z pojęcia „zmienna” i siłą nawyku oczekujemy, że będzie ona miała jakąś nazwę. Termin ten pozwala nam wskazać pamięciową szufladkę, w której znajdziemy wartość. W Clojure takie podejście mogłoby wprowadzać w błąd, ponieważ możemy stwarzać zmienne pozbawione nazw (obiekty referencyjne), a także nazywać wartości, które wcale zmiennymi nie są.
W języku Clojure mamy do czynienia z kilkoma rodzajami powiązań:
-
Zmienne globalne to powiązania:
- symboli z obiektami typu
Varw przestrzeniach nazw, - symboli z klasami Javy w przestrzeniach nazw.
- symboli z obiektami typu
-
Powiązania leksykalne to powiązania symboli z wartościami w wektorze powiązań formy specjalnej
let. -
Wektory parametryczne to formy powiązaniowe symboli z przyjmowanymi argumentami w definicjach funkcji i makr .
-
Powiązania strukturalne to abstrakcyjne powiązania:
- symboli z wartościami na wskazanych pozycjach kolekcji sekwencyjnych,
- symboli z wartościami identyfikowanymi kluczami kolekcji asocjacyjnych.
-
Obiekty typów referencyjnych to powiązania obiektów z wskazywanymi przez nie wartościami bieżącymi.
Ostatnia pozycja wymaga wyjaśnienia, ponieważ – jak łatwo zauważyć – nie zawiera wzmianki o żadnym symbolu, a wielokrotnie przecież wspominaliśmy, że to właśnie symbole służą do identyfikowania innych obiektów.
W tym miejscu warto sobie przypomnieć, że w Clojure symbole samodzielnie nie
przechowują odwołań do wartości – tę funkcję pełnią obiekty referencyjne (np. typu
Var w przypadku zmiennych globalnych). Wynika to z przyjętego modelu
zarządzania zmiennym stanem.
;; zmienna globalna
;; wartość początkowa wskazywana przez x to 1

(def x 1)
;=> #'user/x

;; wektor parametryczny definicji funkcji
;; dwa pierwsze argumenty staną się parametrami a i b

(fn [a b] (+ a b))
;=> #<Fn@5af25442 user/eval14406[fn]>

;; powiązanie leksykalne
;; symbol a identyfikuje wartość 1

(let [a 1]
  a)
;=> 1

;; dekompozycja pozycyjna w let
;; symbol a powiązany z wartością 1 przez pozycję
;; symbol b powiązany z wartością 2 przez pozycję

(let [[a b] '(1 2 8)]
  (+ a b))
;=> 3

;; dekompozycja asocjacyjna w let
;; symbol a powiązany z wartością 1 przez klucz :a
;; symbol b powiązany z wartością 2 przez klucz :b

(let [{a :a b :b} {:a 1 :b 2 :c 8}]
  (+ a b))
;=> 3

;; dekompozycja asocjacyjna w let (użycie :keys)
;; symbol a powiązany z wartością 1 przez klucz :a
;; symbol b powiązany z wartością 2 przez klucz :b

(let [{:keys [:a :b]} {:a 1 :b 2 :c 8}]
  (+ a b))
;=> 3

;; powiązanie obiektu referencyjnego typu Var z wartością

(with-local-vars [x 5] x)
;=> #'Var: --unnamed-->

;; powiązanie obiektu referencyjnego typu Atom z wartością

(atom 5)
;=> #<Atom@a1cb453 5>
;; zmienna globalna
;; wartość początkowa wskazywana przez x to 1

(def x 1)
;=> #'user/x

;; wektor parametryczny definicji funkcji
;; dwa pierwsze argumenty staną się parametrami a i b

(fn [a b] (+ a b))
;=> #<Fn@5af25442 user/eval14406[fn]>

;; powiązanie leksykalne
;; symbol a identyfikuje wartość 1

(let [a 1]
  a)
;=> 1

;; dekompozycja pozycyjna w let
;; symbol a powiązany z wartością 1 przez pozycję
;; symbol b powiązany z wartością 2 przez pozycję

(let [[a b] '(1 2 8)]
  (+ a b))
;=> 3

;; dekompozycja asocjacyjna w let
;; symbol a powiązany z wartością 1 przez klucz :a
;; symbol b powiązany z wartością 2 przez klucz :b

(let [{a :a b :b} {:a 1 :b 2 :c 8}]
  (+ a b))
;=> 3

;; dekompozycja asocjacyjna w let (użycie :keys)
;; symbol a powiązany z wartością 1 przez klucz :a
;; symbol b powiązany z wartością 2 przez klucz :b

(let [{:keys [:a :b]} {:a 1 :b 2 :c 8}]
  (+ a b))
;=> 3

;; powiązanie obiektu referencyjnego typu Var z wartością

(with-local-vars [x 5] x)
;=> #'Var: --unnamed-->

;; powiązanie obiektu referencyjnego typu Atom z wartością

(atom 5)
;=> #<Atom@a1cb453 5>
Zobacz także:
- „Powiązania i przestrzenie nazw”, rozdział VI.
Kolekcje
Kolekcja (ang. collection) to struktura danych, która pozwala przechowywać pewną liczbę elementów.
Listy
W Lispie najczęściej używaną strukturą danych jest lista, która – jak mieliśmy okazję zauważyć – służy zarówno do składniowej organizacji kodu programu (listowe S-wyrażenia), jak i do przechowywania uporządkowanej kolekcji elementów dla potrzeb logiki aplikacji. Warto wyobrażać sobie listę jako sposób aranżacji danych, a nie tylko symboliczny zapis z nawiasami.
Istnieje kilka rodzajów list. Najczęściej używane w dialektach Lispu to tzw. listy połączone (ang. linked lists), a dokładniej listy jednokierunkowe (ang. singly linked lists). Cechuje je możliwość elastycznego łączenia ze sobą elementów i szybkiego dodawania nowych do ich początków. Właśnie dlatego dobrze spełniają swe zadanie jako pamięciowe reprezentacje struktur lispowych programów.
Listy we wczesnych Lispach
Historycznie rzecz ujmując, każdy węzeł listy (w Lispie nazywany komórką cons, ang. cons cell) ma dwa sloty: pierwszy wskazuje na wartość bieżącego elementu, a drugi na kolejny element listy (kolejną komórkę cons). Tak naprawdę są to po prostu dwa wskaźniki, które mogą odnosić się do dowolnych wartości.
Dostęp do pierwszego slotu każdego z elementów nazywamy car (z ang. Contents
of the Address part of Register number), a do drugiego cdr (z ang. Contents
of the Decrement part of Register number). Etymologia tych dziwnych nazw pochodzi
z czasów, gdy implementowano Lispa na komputerze IBM 704 (lata
pięćdziesiąte). Maszyna ta miała specjalną instrukcję, która dzieliła 36-bitowe słowo
maszynowe na 4 części – car i cdr to skrócone etykiety dwóch pierwszych,
a w Lispie znalazły się dlatego, że autor używał ich do dzielenia zawartości
wewnętrznej struktury reprezentującej komórkę listy. Żargonowo pierwszy slot komórki
cons określa się więc skrótem CAR, a drugi CDR.
Nic nie stoi na przeszkodzie, aby lista zawierała w sobie inną listę:
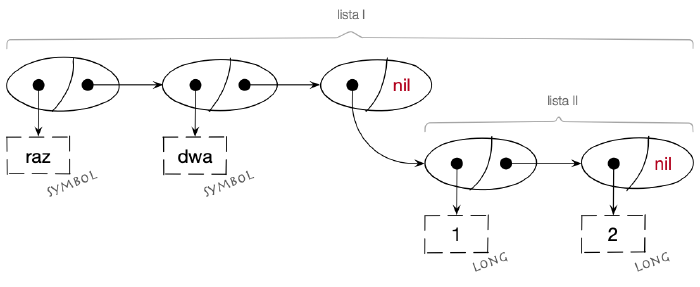
W kodzie możemy wyrazić powyższą strukturę jako:
(raz dwa (1 2))
(raz dwa (1 2))
czyli:
1(raz   ; pierwszy element listy
2 dwa   ; drugi element listy
3 (     ; trzeci element listy – lista zagnieżdżona
4  1    ; pierwszy element zagnieżdżonej listy
5  2))  ; drugi element zagnieżdżonej listy
(raz   ; pierwszy element listy
 dwa   ; drugi element listy
 (     ; trzeci element listy – lista zagnieżdżona
  1    ; pierwszy element zagnieżdżonej listy
  2))  ; drugi element zagnieżdżonej listy
A tak wyglądałby zapis z użyciem tzw. notacji pełnej, która w Clojure nie jest używana. W każdej parze nawiasów znajdziemy dwa sloty oddzielone znakiem kropki:
(raz . (dwa . ((1 . (2 . nil)) . nil)))
(raz . (dwa . ((1 . (2 . nil)) . nil)))
Kropki oddzielają tu rejestry komórek CAR i CDR, a elementy nil oznaczają końce
list. Jeżeli drugi slot (CDR) ma wskazywać na kolejny element listy, w zapisie ten
drugi jest umieszczany po kropce i ujmowany w nawiasy.
Pamiętajmy jednak, że zapis (raz dwa (1 2)) jest poprawnym S-wyrażeniem, ale nie
jest formą, chyba że zdefiniujemy funkcję nazwaną raz, a symbol dwa skojarzymy
z jakąś wartością. Możemy też użyć cytowania i odebrać konstrukcji
specjalne znaczenie, aby wyrażała formę stałą:
'(raz dwa (1 2))
'(raz dwa (1 2))
W pierwszych wydaniach języka Lisp listy tworzyło się z użyciem funkcji cons
(z ang. construct, pol. konstruować). Na przykład:
(cons 'raz
      (cons 'dwa
            (cons (cons 1
                        (cons 2 nil))
                  nil)))
(cons 'raz (cons 'dwa (cons (cons 1 (cons 2 nil)) nil)))
Co można przedstawić też jako:
(cons 'raz
(cons 'dwa
(cons (cons 1
(cons 2 nil))
nil)))
Takie budowanie list może i gimnastykuje umysł, jednak nie służy produktywnemu
pisaniu programów. Obecnie niektóre z dialektów Lispu zrezygnowały z obsługi notacji
pełnej, chociaż funkcji cons nadal się używa, ale raczej
do przeprowadzania operacji na istniejących listach, niż do ich konstruowania od
zera.
Listy w Clojure
W języku Clojure listy reprezentowane są obiektowym typem danych systemu gospodarza
o nazwie clojure.lang.PersistentList. Obiekty tego typu znajdziemy w drzewie
składniowym, gdzie odzwierciedlą listowe S-wyrażenia, a także w danych aplikacji, gdy
użyto funkcji list lub wytworzono literalną listę przez
zacytowanie jej symbolicznie wyrażonej postaci.
1(list 1 2 3)     ; użycie funkcji list (argumenty będą wartościowane)
2(quote (1 2 3))  ; lista literalna (argumenty nie będą wartościowane)
3'(1 2 3)         ; lista literalna (argumenty nie będą wartościowane)
(list 1 2 3)     ; użycie funkcji list (argumenty będą wartościowane)
(quote (1 2 3))  ; lista literalna (argumenty nie będą wartościowane)
'(1 2 3)         ; lista literalna (argumenty nie będą wartościowane)
Wewnętrznie obiekty typu PersistentList są listami dwukierunkowymi (ang. doubly
linked lists), chociaż cecha ta jest ukrywana przed programistą. Poza tym w Clojure
lista (jak większość struktur danych) jest niemutowalna, tzn. chcąc wprowadzić
zmianę w jej strukturze nigdy nie modyfikuje się reprezentującego ją obiektu, lecz
wytwarza nowy, który różni się od poprzedniego.
Zobacz także:
„Listy”, rozdział IX.
Sekwencje i obiekty Cons
Poza hermetycznymi listami w Clojure znajdziemy również obiekty typu Cons
(a dokładniej clojure.lang.Cons). Są one najbliższym odpowiednikiem komórek cons
znanych z innych dialektów języka Lisp. Dokładniej rzecz ujmując, z użyciem cons
możemy konstruować tzw. sekwencje (ang. sequences), czyli abstrakcyjne
kolekcje, które cechuje jednolity interfejs dostępu w postaci trzech podstawowych
operacji:
- odczyt wartości przechowywanej w komórce,
- odczyt następnej komórki połączonej z bieżącą,
- przyłączanie nowej komórki do istniejącej.
Odniesienia do wartości dowolnych typów możemy umieszczać w obiektach Cons i łączyć
w sekwencje z użyciem funkcji cons. Przyjmuje ona dwa argumenty: wartość
i obiekt, który również wyposażono w sekwencyjny interfejs (zaliczamy do nich
m.in. listy, wektory i mapy). Wartością zwracaną będzie komórka Cons, dla
której następną będzie podana jako argument.
Jeżeli podanym istniejącym obiektem będzie nil, zwrócona zostanie
jednoelementowa lista.
1(def pierwszy (cons 3 nil))       ; powstaje lista (3)
2(def drugi    (cons 2 pierwszy))  ; powstaje cons(2)-->(3)
3(def ostatni  (cons 1 drugi))     ; powstaje cons(1)-->cons(2)-->(3)
4
5(first ostatni)        ; => 1     ; wartość w ostatnio dodanej
6(first (rest ostatni)) ; => 2     ; wartość w kolejnej
(def pierwszy (cons 3 nil))       ; powstaje lista (3)
(def drugi    (cons 2 pierwszy))  ; powstaje cons(2)-->(3)
(def ostatni  (cons 1 drugi))     ; powstaje cons(1)-->cons(2)-->(3)

(first ostatni)        ; => 1     ; wartość w ostatnio dodanej
(first (rest ostatni)) ; => 2     ; wartość w kolejnej
Z użyciem Cons możemy zespolić nie tylko pojedyncze wartości, ale również
kolekcje (np. zwykłe listy). Mamy wtedy do czynienia ze
strukturą złożoną, którą można wyrazić na przykład tak:
(cons (list 1 2 3)
      (cons (list 4 5 6)
            (cons 10
                  ())))

; => ((1 2 3) (4 5 6) 10)
Powyższe struktury bywają wykorzystywane do szybkiego łączenia już zgrupowanych wartości w większe zestawy, które dopiero podczas odczytywania są wypłaszczane, aby uzyskiwać indywidualne wartości.
(flatten
    (cons '(1 2 3) (cons '(4 5 6) (cons 10 nil))))

; => (1 2 3 4 5 6 10)
Zobacz także:
„Komórki cons”, rozdział X.
Wektory
Wektor (ang. vector) to uporządkowana kolekcja wartości indeksowana z użyciem liczb całkowitych począwszy od 0 (pierwszy element). W kodzie programu do wyrażania wektorów używamy literału wektorowego, możemy też posłużyć się kilkoma wbudowanymi funkcjami.
Wektory są w Clojure reprezentowane obiektami typu
clojure.lang.PersistentVector. Cechuje je bardzo szybkie wyszukiwanie danych
i dodawanie nowych elementów do ich końców. Wektory są również funkcjami – przyjmują
jeden argument – numer indeksu, którego wartość elementu będzie zwrócona.
;; tworzenie wektora (funkcja)

(vector 1 2 3 4)
;=> [1 2 3 4]

;; tworzenie wektora z S-wyrażenia (literał)

[1 2 3 4]
;=> [1 2 3 4]

;; tworzenie wektora z innej kolekcji

(vec (list 1 2 3 4))
;=> [1 2 3 4]

;; przeszukiwanie wektora (element o indeksie 0)

([1 2 3 4] 0)
;=> 1
;; tworzenie wektora (funkcja)

(vector 1 2 3 4)
;=> [1 2 3 4]

;; tworzenie wektora z S-wyrażenia (literał)

[1 2 3 4]
;=> [1 2 3 4]

;; tworzenie wektora z innej kolekcji

(vec (list 1 2 3 4))
;=> [1 2 3 4]

;; przeszukiwanie wektora (element o indeksie 0)

([1 2 3 4] 0)
;=> 1
Zobacz także:
- „Wektory”, rozdział IX.
Mapy
Mapa (ang. map) to asocjacyjna kolekcja, która przechowuje odwzorowania kluczy na wartości. Klucze i wartości mogą być danymi dowolnego typu, jednak ten sam klucz musi być niepowtarzalny w obrębie danej mapy. Przeszukiwanie map w celu znalezienia wartości identyfikowanej kluczem jest bardzo szybkie, podobnie jak dodawanie nowych elementów.
W Clojure mapy reprezentowane są następującymi typami danych:
clojure.lang.PersistentHashMap(mapa bazująca na tablicach mieszających),clojure.lang.PersistentArrayMap(mapa bazująca na zwykłych tablicach),clojure.lang.PersistentTreeMap(mapa sortowana).
W kodzie programu do wyrażania map używamy literału mapowego w postaci
nawiasów klamrowych zawierających pary wyrażeń. Możemy też skorzystać z funkcji
hash-map, aby wyrazić pary kolejnymi argumentami wywołania.
;; tworzenie mapy (funkcja)

(hash-map :a 1 :b 2)
;=> {:a 1 :b 2}

;; tworzenie mapy sortowanej (funkcja)

(sorted-map :a 1 :b 2)
;=> {:a 1 :b 2}

;; tworzenie mapy z S-wyrażenia (literał)

{:a 1 :b 2}
;=> {:a 1 :b 2}

;; tworzenie mapy z S-wyrażenia (literał)

{:a 1 :b (+ 1 1)}
;=> {:a 1 :b 2}

;; tworzenie mapy z dwóch sekwencyjnych kolekcji

(zipmap [:a :b] [1 2])
;=> {:a 1 :b 2}

;; tworzenie mapy z sekwencji par

(into {} [[:a 1] [:b 2]])
;=> {:a 1 :b 2}

;; tworzenie mapy z sekwencji

(apply hash-map [:a 1 :b 2])
;=> {:a 1 :b 2}
;; tworzenie mapy (funkcja)

(hash-map :a 1 :b 2)
;=> {:a 1 :b 2}

;; tworzenie mapy sortowanej (funkcja)

(sorted-map :a 1 :b 2)
;=> {:a 1 :b 2}

;; tworzenie mapy z S-wyrażenia (literał)

{:a 1 :b 2}
;=> {:a 1 :b 2}

;; tworzenie mapy z S-wyrażenia (literał)

{:a 1 :b (+ 1 1)}
;=> {:a 1 :b 2}

;; tworzenie mapy z dwóch sekwencyjnych kolekcji

(zipmap [:a :b] [1 2])
;=> {:a 1 :b 2}

;; tworzenie mapy z sekwencji par

(into {} [[:a 1] [:b 2]])
;=> {:a 1 :b 2}

;; tworzenie mapy z sekwencji

(apply hash-map [:a 1 :b 2])
;=> {:a 1 :b 2}
Zobacz także:
- „Mapy”, rozdział IX.
Zbiory
Zbiór (ang. set) jest strukturą danych, która pozwala przechowywać elementy o dowolnych wartościach z zastrzeżeniem, że dana wartość może pojawić się w zbiorze tylko raz. Zbiory cechuje bardzo szybkie dodawanie i wyszukiwanie elementów. W Clojure istnieją wbudowane funkcje przeznaczone do przeprowadzania operacji na zbiorach, np. złączenie, projekcja, suma itd.
Zbiory reprezentowane są obiektami następujących typów danych:
clojure.lang.PersistentSet(zbiór bazujący na tablicach mieszających),clojure.lang.PersistentTreeSet(zbiór sortowany).
;; tworzenie zbioru (funkcja)

(hash-set :a :b :c)
;=> #{:a :b :c}

;; tworzenie zbioru sortowanego (funkcja)

(sorted-set :a :b :c)
;=> #{:a :b :c}

;; tworzenie zbioru z S-wyrażenia (literał)

#{:a :b :c}
;=> #{:a :b :c}

;; tworzenie zbioru z S-wyrażenia (literał)

#{:a :b (keyword "c")}
;=> #{:a :b :c}

;; tworzenie zbioru z sekwencji

(set [:a :b :c])
;=> #{:a :b :c}
;; tworzenie zbioru (funkcja)

(hash-set :a :b :c)
;=> #{:a :b :c}

;; tworzenie zbioru sortowanego (funkcja)

(sorted-set :a :b :c)
;=> #{:a :b :c}

;; tworzenie zbioru z S-wyrażenia (literał)

#{:a :b :c}
;=> #{:a :b :c}

;; tworzenie zbioru z S-wyrażenia (literał)

#{:a :b (keyword "c")}
;=> #{:a :b :c}

;; tworzenie zbioru z sekwencji

(set [:a :b :c])
;=> #{:a :b :c}
Zobacz także:
- „Zbiory”, rozdział IX.
Funkcje
Funkcja (ang. function) to konstrukcja zawierająca kod, który w trakcie wywołania dokonuje obliczania wartości dla podanego zestawu argumentów (ang. arguments). W językach czysto funkcyjnych jest to jedyny rezultat użycia funkcji, a w pozostałych (m.in. w Clojure) funkcje mogą wywoływać tzw. efekty uboczne (ang. side effects), tzn. poza zwróceniem wartości wpływać na otoczenie (np. modyfikować wartość zmiennej globalnej czy korzystać z podsystemu wejścia/wyjścia).
Poza tym rezultat działań funkcji w Clojure może zależeć od otoczenia. Przykładem będzie odwoływanie się w obliczeniach do globalnych obiektów referencyjnych wyrażających pewien zmienny stan bądź korzystanie z wartości pochodzących z leksykalnego otoczenia definicji funkcji. W tym drugim przypadku funkcję taką nazwiemy domknięciem (ang. closure).
Definicja funkcji w Clojure składa się z listowego S-wyrażenia zawierającego:
- wektorowe S-wyrażenie definiujące listę argumentów (ang. argument list),
- jedno lub więcej S-wyrażeń stanowiących ciało funkcji (ang. function body).
W języku Clojure możemy również korzystać z funkcji wieloczłonowych, które mogą obsługiwać więcej, niż jeden zestaw argumentów. W ich przypadku składnia definicji będzie nieco inna.
Wartością zwracaną (ang. return value) funkcji jest obliczona wartość ostatniego S-wyrażenia z jej ciała (lub z ciała danej wartościowości w przypadku funkcji wieloczłonowej).
W Clojure do tworzenia funkcji anonimowych (ang. anonymous functions) używamy
formy specjalnej fn, a do tworzenia funkcji nazwanych (ang. named
functions) makra defn. Funkcje anonimowe to obiekty funkcyjne, które nie
mają nadanych nazw. Funkcje nazwane mają w Clojure nazwy wyrażone zmiennymi
globalnymi.
1(defn krzycz          ; definicja funkcji nazwanej
2  [napis]             ; wektor z argumentami
3  (print napis "!"))  ; wywołanie print z parametrem napis
4
5(krzycz "Witaj, Lispie")  ; wywołanie funkcji z argumentem
6;=>> Witaj, Lispie!       ; rezultat wywołania na ekranie
7;=> nil                   ; zwracana wartość
(defn krzycz          ; definicja funkcji nazwanej
  [napis]             ; wektor z argumentami
  (print napis "!"))  ; wywołanie print z parametrem napis

(krzycz "Witaj, Lispie")  ; wywołanie funkcji z argumentem
;=>> Witaj, Lispie!       ; rezultat wywołania na ekranie
;=> nil                   ; zwracana wartość
Możemy też stworzyć wersję anonimową powyższej funkcji, jednak dla potrzeb przykładu musimy całą konstrukcję umieścić w S-wyrażeniu reprezentującym formę wywołania funkcji, aby móc zaobserwować rezultat jej działania:
1(                       ; forma wywołania funkcji
2  (fn                   ; definicja funkcji anonimowej
3    [napis]             ; wektor z argumentami
4    (print napis "!"))  ; wywołanie print z parametrem napis
5  "Witaj, Lispie!")     ; argument wywołania funkcji
6
7;=>> Witaj, Lispie!     ; rezultat wywołania na ekranie
8;=> nil                 ; zwracana wartość
(                       ; forma wywołania funkcji
  (fn                   ; definicja funkcji anonimowej
    [napis]             ; wektor z argumentami
    (print napis "!"))  ; wywołanie print z parametrem napis
  "Witaj, Lispie!")     ; argument wywołania funkcji

;=>> Witaj, Lispie!     ; rezultat wywołania na ekranie
;=> nil                 ; zwracana wartość
Powyższe można też wyrazić z użyciem literału funkcji anonimowej:
1(                    ; forma wywołania funkcji
2  #(print %1 "!")    ; definicja i wywołanie print z pierwszym parametrem
3  "Witaj, Lispie!")  ; argument wywołania funkcji
4
5;=>> Witaj, Lispie!  ; rezultat wywołania na ekranie
6;=> nil              ; zwracana wartość
(                    ; forma wywołania funkcji
  #(print %1 "!")    ; definicja i wywołanie print z pierwszym parametrem
  "Witaj, Lispie!")  ; argument wywołania funkcji

;=>> Witaj, Lispie!  ; rezultat wywołania na ekranie
;=> nil              ; zwracana wartość
Nic nie stoi też na przeszkodzie, aby zdefiniować funkcję anonimową, a następnie samodzielnie przypisać jej nazwę:
1(def krzycz               ; definicja zmiennej globalnej
2  (fn                     ; definicja funkcji anonimowej
3    [napis]               ; wektor z argumentami
4    (print napis "!")))   ; wywołanie print z parametrem napis
5
6(krzycz "Witaj, Lispie")  ; wywołanie funkcji z argumentem
7;=>> Witaj, Lispie!       ; rezultat wywołania na ekranie
8;=> nil                   ; zwracana wartość
(def krzycz               ; definicja zmiennej globalnej
  (fn                     ; definicja funkcji anonimowej
    [napis]               ; wektor z argumentami
    (print napis "!")))   ; wywołanie print z parametrem napis

(krzycz "Witaj, Lispie")  ; wywołanie funkcji z argumentem
;=>> Witaj, Lispie!       ; rezultat wywołania na ekranie
;=> nil                   ; zwracana wartość
W powyższym przykładzie definiujemy zmienną globalną krzycz, z wartością początkową
przypisaną do rezultatu wywołania formy specjalnej fn, którym będzie obiekt
funkcyjny (ang. function object) – reprezentacja istniejącej funkcji.
W Lispie funkcje są jednostkami pierwszej kategorii (ang. first-class citizens), tzn. wartościami, które mogą być traktowane tak, jak każde inne: przekazywane jako argumenty, albo zwracane jako rezultaty działania funkcji.
Zobacz także:
- „Funkcje i domknięcia”, rozdział VIII.
Wartości logiczne
Do wyrażania wartości logicznych w Clojure możemy użyć singletonów typu
java.lang.Boolean: true oznaczającego logiczną prawdę i false
oznaczającego logiczny fałsz. Wartości te zwracane są przez wbudowane predykaty
(funkcje, które na podstawie argumentów zwracają logiczną prawdę lub fałsz)
i konstrukcje warunkowe.
Wartość nil
Literał nil oznacza w Clojure wartość braku. Na JVM jest reprezentowany przez
javowe null, lecz Clojure nadaje mu jawne reguły dotyczące kolekcji, sekwencji,
równości i prawdziwości.
Funkcje mogą zwracać nil, gdy nie ma bardziej swoistego wyniku, a wiele operacji
wyszukiwania używa go dla brakującej wartości. W warunkach nil i false są
jedynymi wartościami fałszywymi. Funkcje sekwencyjne także używają nil do
oznaczenia braku sekwencji, w tym końca osiągniętego przez next.
Komentarze
Komentarze w programach komputerowych służą do objaśniania fragmentów kodu źródłowego w języku naturalnym. Mogą pełnić funkcję dokumentacyjną lub zawierać notatki dotyczące postępów w realizacji pewnych zadań. Czasami też wykorzystuje się je do zaprezentowania rezultatów obliczeń przykładowych form.
W Clojure komentarz rozpoczynamy znakiem średnika ;, po którym umieszczamy dowolny
tekst. Komentarzem będzie dowolna sekwencja znaków, aż do końca linii, w której go
rozpoczęto:
 1(print "Witaj, Lispie!")  ; to jest komentarz
 2
 3;; To jest dłuższy komentarz
 4;; zapisany zgodnie z konwencją
 5;; poprzedzania każdej linii
 6;; dwoma średnikami.
 7
 8;; Poniższe komentarze
 9;; służą prezentowaniu rezultatów obliczeń.
10
11(+ 2 2)  ; => 4
12(- 2 2)  ; => 0
13
14(+ 2 2)
15; => 4
16
17'(1 2 3)
18; => (1 2 3)
(print "Witaj, Lispie!")  ; to jest komentarz

;; To jest dłuższy komentarz
;; zapisany zgodnie z konwencją
;; poprzedzania każdej linii
;; dwoma średnikami.

;; Poniższe komentarze
;; służą prezentowaniu rezultatów obliczeń.

(+ 2 2)  ; => 4
(- 2 2)  ; => 0

(+ 2 2)
; => 4

'(1 2 3)
; => (1 2 3)
Forma komentująca
Poza komentarzami składniowymi, wyrażanymi średnikiem, w Clojure istnieje specjalne makro, które pozwala wyłączać obliczanie wskazanego S-wyrażenia:
(comment
    (print "Witaj, Lispie!")
    123)
(comment
    (print "Witaj, Lispie!")
    123)
Warto zauważyć, że comment jest konstrukcją, której jako argumenty należy przekazać
poprawne składniowo symboliczne wyrażenia.
Wartością zwracaną przez makro jest nil.
Ignorowanie następnej formy
Makro czytnika #_ sprawia, że czytnik pomija następną kompletną formę. Pominięta
forma nie dociera do analizy kompilatora, co jest działaniem wcześniejszym i silniejszym
niż samo powstrzymanie jej wartościowania:
#_ (print "Witaj, Lispie!")    ; cała forma zostaje pominięta
(#_#_ print "Witaj, Lispie!")  ; pominięte są dwie formy, pozostaje ()
(print #_ "Witaj, Lispie!")    ; pominięty jest łańcuch, pozostaje (print)
[#_#_ 1 2 3]                   ; pominięte są 1 i 2, pozostaje [3]
#_ (print "Witaj, Lispie!")    ; cała forma zostaje pominięta
(#_#_ print "Witaj, Lispie!")  ; pominięte są dwie formy, pozostaje ()
(print #_ "Witaj, Lispie!")    ; pominięty jest łańcuch, pozostaje (print)
[#_#_ 1 2 3]                   ; pominięte są 1 i 2, pozostaje [3]
Konstrukcje sterujące
Clojure wyposażono w wiele form specjalnych i makr, które służą do sterowania procesem wartościowania wyrażeń, m.in. kolejnością, liczbą powtórzeń czy warunkowaniem przetwarzania.
Wyrażenia warunkowe
Znane z języków imperatywnych instrukcje warunkowe mają w Lispach odpowiedniki jako warunkowe formy specjalne lub makra. W odróżnieniu od zwykłego wywołania funkcji konstrukcje te sterują tym, które formy argumentów zostaną zwartościowane. Dzięki temu można wybrać gałąź bez wartościowania pozostałych.
Formy specjalne i makra będą omówione później. Podstawowa różnica polega na tym, że makro rozwija się do form zastępczych, które są ponownie analizowane, natomiast forma specjalna jest obsługiwana bezpośrednio przez kompilator według wbudowanej gramatyki.
Wykonywanie warunkowe, if
Forma specjalna if służy do warunkowego obliczania wyrażeń.
Użycie:
(if predykat wyrażenie-prawda wyrażenie-fałsz?).
Forma if przyjmuje dwa obowiązkowe argumenty. Pierwszym jest warunek do
przeliczenia, który (jeżeli nie będzie przyjmował ani wartości false ani
nil) sprawi, że kolejny argument zostanie również obliczony. Jeżeli podano
opcjonalny trzeci argument, będzie on obliczony tylko wtedy, gdy pierwszy argument
ma wartość false lub nil.
Forma specjalna if zwraca wartość ostatnio obliczonego wyrażenia lub nil,
jeżeli nie podano trzeciego argumentu, a pierwsze wyrażenie zwróciło logiczny
fałsz.
if
(if (= 2 2)
  "równe"
  "różne")
; => "równe"
Wraz z formą if często wykorzystywane jest makro and, które służy do
wyrażania operacji koniunkcji logicznej (iloczynu logicznego). Dokonuje ono
obliczania wartości wyrażeń podanych jako jego argumenty (w porządku występowania),
dopóki ich wartością jest logiczna prawda (nie wartość false i nie
nil). Zwracaną wartością jest wtedy wartość ostatnio podanego
wyrażenia. Jeżeli któreś z wyrażeń zwróci wartość false lub nil, przetwarzanie
kolejnych argumentów zostaje wstrzymane i zwracana jest jego wartość.
and
(if (and (= 2 2) (< 2 3)) true)
; => true
Innym makrem, które znajdziemy w towarzystwie if jest or. Służy ono do
wyrażania operacji sumy logicznej (logicznej alternatywy). Makro to oblicza
wartości kolejnych wyrażeń podanych jako jego argumenty (w kolejności występowania)
do momentu, aż wartością któregoś będzie logiczna prawda (nie wartość
false i nie nil). Zwracaną wartością jest wtedy wartość ostatnio
przetwarzanego wyrażenia. Jeżeli wartości wszystkich wyrażeń to false lub
nil, zwracana jest wartość ostatniego podanego wyrażenia (false lub
nil).
or
(if (or (= 2 2) (< 4 3)) true)
; => true
Wykonywanie warunkowe, if-not
Makro if-not jest odwrotną wersją formy specjalnej if.
Użycie:
(if-not predykat wyrażenie-fałsz wyrażenie-prawda?).
Makro przyjmuje dwa obowiązkowe argumenty. Pierwszym jest warunek do
przeliczenia, który jeżeli będzie przyjmował wartość logicznego fałszu (false
lub nil), sprawi, że kolejny argument zostanie również obliczony. Jeżeli podano
opcjonalny trzeci argument, będzie on obliczony tylko wtedy, gdy pierwszy
argument reprezentuje logiczną prawdę (ma wartość różną od false
i różną od nil).
Makro if-not zwraca wartość ostatnio obliczonego wyrażenia lub nil, jeżeli
nie podano trzeciego argumentu, a pierwsze wyrażenie zwróciło logiczną prawdę.
if-not
(if-not (= 2 2)
  "różne"
  "równe")
; => "równe"
Wykonywanie warunkowe, when
Makro when działa podobnie do konstrukcji if, przy czym jest nieco
prostsze, ponieważ nie ma w nim miejsca na wyrażenie alternatywne (wykonywane, gdy
podany warunek nie jest spełniony).
Użycie:
(when predykat & wyrażenie…).
Pierwszy argument powinien być formą wyrażającą warunek logiczny (zwracającą
true lub false, ew. nil), a każdy pozostały będzie
potraktowany jak wyrażenie, które zostanie obliczone, gdy wartością zwracaną przez
konstrukcję warunkową będzie logiczna prawda (wartość różna od false i różna od
nil).
when
1(when (= 2 2)
2  (println "można podać")
3  (println "wiele wyrażeń"))
4
5; >> można podać
6; >> wiele wyrażeń
(when (= 2 2)
  (println "można podać")
  (println "wiele wyrażeń"))

; >> można podać
; >> wiele wyrażeń
Wykonywanie warunkowe, when-not
Makro when-not jest odwrotną wersją makra when.
Użycie:
(when-not predykat & wyrażenie…).
Pierwszy argument powinien być predykatem, a każdy pozostały będzie potraktowany
jak wyrażenie, które zostanie obliczone, gdy wartością predykatu będzie logiczny
fałsz (wartość false lub nil).
when-not
1(when-not (= 2 1)
2  (println "można podać")
3  (println "wiele wyrażeń"))
4
5; >> można podać
6; >> wiele wyrażeń
(when-not (= 2 1)
  (println "można podać")
  (println "wiele wyrażeń"))

; >> można podać
; >> wiele wyrażeń
Lista warunków, cond
Makro cond pozwala zapisać listę warunków z przypisanymi do niej wyrażeniami, które
zostaną obliczone, gdy dany warunek będzie spełniony.
Użycie:
(cond & para…),
gdzie para to:
predykat wyrażenie,:else wyrażenie-domyślne.
Makro przyjmuje parzystą liczbę argumentów. Dla każdej pary sprawdza, czy podane
wyrażenie warunkowe zwraca wartość różną od false i od nil. Jeżeli tak jest,
wartościowany będzie przypisany mu argument z pary (wyrażenie) i przetwarzanie
dalszych argumentów zostanie wstrzymane, a zwracaną wartością będzie wartość
obliczonego wyrażenia.
Opcjonalnie można dodać ostatnią parę (opcję), której pierwszy element równy będzie
:else. Przypisane mu wyrażenie zostanie obliczone, gdy żadne wcześniejsze nie
zakończyło pracy. Pozwala to ustawiać domyślną wartość zwracaną.
Jeżeli nie podano opcji domyślnej, a żaden warunek nie był spełniony, zwracaną
wartością będzie nil.
cond
1(cond
2  (= 2 3) "2 i 3 są równe"
3  (< 2 3) "2 jest mniejsze niż 3"
4  :else   "nic")
5
6; => "2 jest mniejsze niż 3"
(cond
  (= 2 3) "2 i 3 są równe"
  (< 2 3) "2 jest mniejsze niż 3"
  :else   "nic")

; => "2 jest mniejsze niż 3"
Lista przypadków, case
Makro case działa podobnie do cond, ale zamiast wyrażeń
warunkowych w opcjach należy podawać stałe wartości, które będą dopasowywane do
wartości pierwszego przekazanego argumentu wywołania.
Użycie:
(case wartość opcja…),
gdzie opcja to:
wartość wyrażenie,(wartość…) wyrażenie,wyrażenie-domyślne.
Jeżeli chcemy porównywać podaną wartość z wieloma z serii dla każdej z możliwych opcji, należy tę serię możliwości zapisać w postaci listowego S-wyrażenia.
Wartości, z którymi porównywana będzie wartość pierwszego argumentu, muszą być stałymi czasu kompilacji. Możemy więc podawać literały albo listy literalnych wartości testowych, ale nie dowolne wyrażenia, których wartości poznamy dopiero podczas działania programu. Wyrażenia obliczane po udanym teście mogą być dowolnymi formami.
Opcjonalnie możliwe jest podanie jako ostatniego argumentu wyrażenia, które zostanie obliczone, jeżeli badana wartość nie spełni żadnego z wcześniej podanych warunków. Warto z tej możliwości korzystać, ponieważ w przeciwnym wypadku program zgłosi wyjątek, gdy żadne z dopasowań nie będzie spełnione.
case
1(def x 'herbatniki) ; x odnosi się do symbolu herbatniki
2
3(case x
4  ""                         "nic"
5  (draże miętusy)       "cukierki"
6  (herbatniki pierniki)  "ciastka"
7  (str x " to produkt nieznany"))
8
9; => "ciastka"
(def x 'herbatniki) ; x odnosi się do symbolu herbatniki

(case x
  ""                         "nic"
  (draże miętusy)       "cukierki"
  (herbatniki pierniki)  "ciastka"
  (str x " to produkt nieznany"))

; => "ciastka"
Symbole i listy użyte jako stałe testowe celowo nie zostały zacytowane. case
jest makrem o własnej składni: te pozycje są danymi testowymi czasu kompilacji,
a nie zwykłymi argumentami funkcji.
Lista warunków z predykatem, condp
Makro condp działa podobnie jak cond, ale jest o wiele bardziej
elastyczne.
Użycie:
(condp predykat wyrażenie & para…)
Jako pierwszy argument należy podać predykat, czyli funkcję, która powinna zwracać wartość logiczną, a jako drugi wyrażenie. Kolejne, nieobowiązkowe argumenty to składające się z par opcje, które mogą być wyrażone następującymi zapisami:
wyrażenie-testowe wyrażenie-wynikowe,wyrażenie-testowe :>> funkcja-wynikowa,wyrażenie-domyślne.
Symboliczny zapis :>> to słowo kluczowe, które ma w kontekście makra
condp specjalne znaczenie.
Dla każdej podanej opcji będzie wartościowana przypisana jej forma wywołania funkcji:
(predykat wyrażenie-warunkowe wyrażenie).
Predykat będzie wywoływany dla każdej podanej w kolejności opcji z dwoma przekazywanymi argumentami. Pierwszy będzie wartością wyrażenia testowego danej opcji, a drugi wyrażeniem podanym jako argument wywołania całego makra.
Jeżeli predykat zwróci wartość odpowiadającą logicznej prawdzie (różną od false
i różną od nil), sprawdzanie kolejnych opcji zakończy się i zostanie zwrócone
wyrażenie wynikowe przypisane do bieżącej opcji lub wartość powstała na skutek
wywołania funkcji wynikowej (w przypadku, gdy użyto słowa kluczowego
:>>). W tym ostatnim przypadku do funkcji (która powinna przyjmować jeden argument)
zostanie przekazana wartość zwracana przez predykat.
W przypadku, gdy jako ostatnią z opcji podano dodatkowe wyrażenie
(wyrażenie-domyślne), jego wartość zostanie zwrócona, jeżeli żadna z opcji nie
zostanie dopasowana do podanych danych. Gdy taka sytuacja wystąpi, ale nie podano
domyślnego wyrażenia, zostanie rzucony IllegalArgumentException.
condp
 1(condp
 2  =           ; predykat
 3  (+ 2 2)     ; wyrażenie (da w wyniku 4)
 4  1 "jeden"   ; opcja 1: łańcuch znakowy
 5  2 "dwa"     ; opcja 2: łańcuch znakowy
 6  3 "trzy"    ; opcja 3: łańcuch znakowy
 7  4 "cztery"  ; opcja 4: łańcuch znakowy
 8  "żadna")    ; wyrażenie opcji domyślnej
 9
10; => "cztery"
(condp
  =           ; predykat
  (+ 2 2)     ; wyrażenie (da w wyniku 4)
  1 "jeden"   ; opcja 1: łańcuch znakowy
  2 "dwa"     ; opcja 2: łańcuch znakowy
  3 "trzy"    ; opcja 3: łańcuch znakowy
  4 "cztery"  ; opcja 4: łańcuch znakowy
  "żadna")    ; wyrażenie opcji domyślnej

; => "cztery"
Dostęp do składowych Javy
Dostęp do składowej, .
Forma specjalna . to w Clojure sposób na dostęp do obiektów Javy. Jest to de
facto operator wyboru składowej (ang. member-access operator).
-
Gdy celem jest symbol nazywający klasę Javy, kompilator potraktuje zapis jako dostęp do statycznej składowej tej klasy.
-
W przeciwnym razie wyrażenie celu zostanie zwartościowane do instancji. Składnia składowej może oznaczać pole albo metodę; poprzedzenie nazwy składowej łącznikiem (
-) jawnie wskazuje dostęp do pola. Podpowiedzi typów mogą pomóc kompilatorowi rozpoznać niejednoznaczne albo przeciążone składowe hosta bez refleksji. -
Jeżeli podano kolejne argumenty poza pierwszym, wywołana zostanie metoda instancji o podanej jako pierwszy argument nazwie. Dodatkowe argumenty zostaną (od lewej do prawej) przekazane do wywołania po ewaluacji ich wartości.
Dodatkowe argumenty mogą być też listowym S-wyrażeniem. W takim przypadku na pierwszym miejscu powinien znajdować się symbol identyfikujący metodę do wywołania.
Istnieje też skrócona składnia, w której kropka poprzedza nazwę składowej na pozycji
operatora, np. (.trim wartość).
.
(. " a " trim)             ; => a
(.trim " a ")              ; => a
(. "abc" substring 0 1)    ; => a
(. "abc" (substring 0 1))  ; => a
(. " a " trim)             ; => a
(.trim " a ")              ; => a
(. "abc" substring 0 1)    ; => a
(. "abc" (substring 0 1))  ; => a
Dostęp do składowych, ..
Makro o nazwie .. jest lukrem składniowym i pozwala wyrażać zagnieżdżony dostęp
do składowych obiektów Javy w czytelny sposób. Efektem jego użycia jest stworzenie
kaskady wywołań omówionej wyżej formy specjalnej ..
W praktyce .. wykonuje serię wywołań metod, w której wynik jednej staje się
obiektem wejściowym dla kolejnej. Każde wyrażenie po .. jest interpretowane
podobnie jak w formie ., ale bez konieczności ręcznego zagnieżdżania.
..
(.. " a " trim length)                             ; => 1
(.. " a " trim length toString (replace "1" "X"))  ; => "X"
(.. " a " trim length)                             ; => 1
(.. " a " trim length toString (replace "1" "X"))  ; => "X"
Organizowanie kodu
Formy Clojure są wyrażeniami i wytwarzają wartości, ale ich wartościowanie może też powodować efekty. Czyste przekształcenia i jawne granice efektów mogą więc współistnieć bez udawania, że każda użyteczna operacja jest czysta.
Grupowanie S-wyrażeń, do
Chyba najbardziej powszechną konstrukcją, która pozwala na chwilę zapomnieć o tym, że
mamy do czynienia z wartościowanymi wyrażeniami i potraktować elementy programu jak
instrukcje jest forma specjalna do. Służy ona do grupowania wielu wyrażeń w taki
sposób, że tylko wartość ostatniego zostanie zwrócona, chociaż ewentualne efekty
uboczne (np. wyświetlanie tekstu na ekranie) będą mogły powstawać we wszystkich.
Użycie:
(do & wyrażenie…).
Forma specjalna do przyjmuje zero lub więcej S-wyrażeń, które będą obliczone
w kolejności ich podawania. Wartością zwracaną będzie rezultat wartościowania
ostatniego z nich.
Jeżeli nie podamy żadnego S-wyrażenia, wartością zwracaną będzie nil.
do
 1(do)
 2; => nil
 3
 4(do 123 456)
 5; => 456
 6
 7(do
 8  (println "test")
 9  123
10  (+ 1 1)
11  (+ 2 2))
12; >> test
13; => 4
(do)
; => nil

(do 123 456)
; => 456

(do
  (println "test")
  123
  (+ 1 1)
  (+ 2 2))
; >> test
; => 4
Przyłączanie argumentu, doto
Makro doto wartościuje cel jeden raz, wstawia wynik po operatorze każdej następnej
formy listowej, wartościuje te formy dla ich efektów i zwraca pierwotny cel.
Najczęściej służy do zapisu serii wywołań metod Javy na jednym obiekcie.
(doto wartość & wyrażenie…).
Makro przyjmuje jedno obowiązkowe wyrażenie celu. Każda następna lista zostanie przekształcona tak, aby wartość celu stała się jej pierwszym argumentem.
Wartością zwracaną przez doto jest zwartościowana wartość celu.
doto
 1(doto 2
 2  (println "za pierwszym razem")
 3  (println "za drugim razem"))
 4
 5; >> 2 za pierwszym razem
 6; >> 2 za drugim razem
 7; => 2
 8
 9(doto (java.util.ArrayList.)
10  (.add 1)
11  (.add 2)
12  (.add 3))
13
14; => [1 2 3]
(doto 2
  (println "za pierwszym razem")
  (println "za drugim razem"))

; >> 2 za pierwszym razem
; >> 2 za drugim razem
; => 2

(doto (java.util.ArrayList.)
  (.add 1)
  (.add 2)
  (.add 3))

; => [1 2 3]
Liczenie czasu, time
Makro time pozwala nam wyświetlić czas wykonania podanego wyrażenia. Przydaje
się, gdy chcemy optymalizować fragmenty programu pod kątem wydajnościowym.
Użycie:
(time wyrażenie).
Argumentem makra powinno być S-wyrażenie, którego wartość będzie obliczona. Można
użyć do, jeżeli chcemy podać więcej wyrażeń.
Wartością zwracaną makra time jest wartość przeliczonego wyrażenia, które podano.
Efektem ubocznym wywołania makra jest wyświetlenie na standardowym wyjściu raportu z czasu wykonywania podanego wyrażenia.
time
1(time 123)
2; >> "Elapsed time: 0.012667 msecs"
3; => 123
4
5(time (Thread/sleep 500))
6; >> "Elapsed time: 505.079375 msecs"
7; => nil
(time 123)
; >> "Elapsed time: 0.012667 msecs"
; => 123

(time (Thread/sleep 500))
; >> "Elapsed time: 505.079375 msecs"
; => nil
Przewlekanie, ->
Makro przewlekania (ang. threading macro), zwane też makrem przewlekania pierwszych argumentów (ang. thread-first macro), umożliwia przedstawianie kodu źródłowego z zagnieżdżonymi wywołaniami w bardziej czytelny sposób. Jego działanie polega na przyjęciu zestawu S-wyrażeń i potraktowaniu każdego poza pierwszym jako formy wywołania (nawet, jeżeli nie ujęto go w nawiasy), a następnie wstawianiu w miejsce pierwszego argumentu każdej z form wartości zwracanej przez wywołanie umieszczone wcześniej. Dzięki temu możemy na chwilę zapomnieć o notacji polskiej.
Użycie:
(-> wyrażenie & wyrażenie…).
Makro przyjmuje wyrażenie początkowe i zero lub więcej form wywołania. Wynikiem jest wartość całego rozwiniętego łańcucha wywołań.
->
1(-> [1 2 3 4]  ; rezultat [1 2 3 4]
2    last       ; rezultat (last [1 2 3 4]) => 4
3    (- 2)      ; rezultat (- 4 2)          => 2
4    println    ; rezultat (println 2)      => nil
5)
6
7; >> 2
(-> [1 2 3 4]  ; rezultat [1 2 3 4]
    last       ; rezultat (last [1 2 3 4]) => 4
    (- 2)      ; rezultat (- 4 2)          => 2
    println    ; rezultat (println 2)      => nil
)

; >> 2
Spójrzmy na te same operacje uszeregowane w kodzie bez używania makra:
(println
  (- (last
      [1 2 3 4]))
     2)

; => nil
; >> 2
Porównajmy obydwa zapisy w postaciach bardziej kompaktowych:
1(println (- (last [1 2 3 4])) 2)   ; zapis zagnieżdżony
2(-> [1 2 3 4] last (- 2) println)  ; liniowy zapis przepływu danych
(println (- (last [1 2 3 4])) 2)   ; zapis zagnieżdżony
(-> [1 2 3 4] last (- 2) println)  ; liniowy zapis przepływu danych
Obie postacie rozwijają się do tych samych zagnieżdżonych wywołań i podlegają tym
samym regułom wartościowania. Różni je układ źródła: -> przedstawia przepływ
danych od lewej do prawej, wstawiając każdą formę pośrednią jako pierwszy argument
kolejnego wywołania.
Przewlekanie ostatnich, ->>
Makro przewlekania ostatnich argumentów (ang. thread-last macro) działa podobnie do makra przewlekania, lecz wartość każdego poprzedniego S-wyrażenia nie będzie podstawiana jako pierwszy, ale jako ostatni argument kolejnego.
Użycie:
(->> wyrażenie & wyrażenie…).
Makro przyjmuje wyrażenie początkowe i zero lub więcej form wywołania. Wynikiem jest wartość całego rozwiniętego łańcucha wywołań.
->>
1(->> [1 2 3 4]  ; rezultat [1 2 3 4]
2     last       ; rezultat (last [1 2 3 4]) => 4
3     (- 2)      ; rezultat (- 2 4)          => -2
4     println    ; rezultat (println -2)     => nil
5)
6
7; => nil
8; >> -2
(->> [1 2 3 4]  ; rezultat [1 2 3 4]
     last       ; rezultat (last [1 2 3 4]) => 4
     (- 2)      ; rezultat (- 2 4)          => -2
     println    ; rezultat (println -2)     => nil
)

; => nil
; >> -2
W powyższym przykładzie widzimy, że różnica w obliczeniach w stosunku do przykładów poprzednich pojawia się w linii nr 3. Dochodzi do zamiany argumentów odejmowania z powodu podstawienia wartości jako drugi argument odejmowania.
Przewlekanie wartościowych, some->
Makro some-> działa podobnie do ->, lecz natychmiast zatrzymuje przewlekanie
i dalsze wartościowanie wyrażeń, gdy którakolwiek forma w łańcuchu zwróci nil.
Przydaje się na przykład wtedy, gdy wyszukiwanie może zwrócić nil, a kolejnych
operacji nie należy wywoływać na tej wartości.
Użycie:
(some-> wyrażenie & wyrażenie…).
Makro przyjmuje wyrażenie początkowe i zero lub więcej form wywołania. Zwraca końcowy
wynik przewlekania albo nil, gdy tylko wynik pośredni będzie równy nil.
some->
1(some-> [1 2 3 4]  ; rezultat [1 2 3 4]
2        (get 50)   ; rezultat (get [1 2 3 4] 50)  => nil
3        (+ 2)      ; brak wartościowania
4        println    ; brak wartościowania
5)
6
7; => nil
(some-> [1 2 3 4]  ; rezultat [1 2 3 4]
        (get 50)   ; rezultat (get [1 2 3 4] 50)  => nil
        (+ 2)      ; brak wartościowania
        println    ; brak wartościowania
)

; => nil
Widzimy, że w linii nr 2 doszło do przerwania dalszego wartościowania S-wyrażeń
z łańcucha, ponieważ forma (get [1 2 3 4] 50) zwróciła nil (przy próbie dostępu
do nieistniejącego elementu o indeksie 50). Spójrzmy co by się stało, gdyby zamiast
some-> użyć ->:
1(-> [1 2 3 4]  ; rezultat [1 2 3 4]
2    (get 50)   ; rezultat (get [1 2 3 4] 50)  => nil
3    (+ 2)      ; rezultat (+ nil 2)  (wyjątek)
4    println    ; brak wartościowania (wyjątek)
5)
6
7; >> java.lang.NullPointerException:
(-> [1 2 3 4]  ; rezultat [1 2 3 4]
    (get 50)   ; rezultat (get [1 2 3 4] 50)  => nil
    (+ 2)      ; rezultat (+ nil 2)  (wyjątek)
    println    ; brak wartościowania (wyjątek)
)

; >> java.lang.NullPointerException:
Zamiast zakończyć łańcuch i zwrócić nil, wartościowanie rzuca wyjątek, gdy +
otrzymuje nil. REPL zgłasza wyjątek i pozostaje dostępny; dalszy los aplikacji
zależy od otaczającej polityki obsługi błędów.
Przewlekanie wartościowych, some->>
Makro some->> działa podobnie do makra some->, ale wartości poprzednio
wyliczonych S-wyrażeń podstawiane są jako ostatnie argumenty kolejnych.
Użycie:
(some->> wyrażenie & wyrażenie…).
Makro przyjmuje wyrażenie początkowe i zero lub więcej form wywołania. Zwraca końcowy
wynik przewlekania albo nil, gdy tylko wynik pośredni będzie równy nil.
some->>
1(some->> [2 4 6 8]      ; rezultat [2 4 6 8]
2         (filter odd?)  ; rezultat (filter odd? [2 4 6 8]) => ()
3         first          ; rezultat (first ()) => nil
4         (+ 2)          ; brak wartościowania
5         println        ; brak wartościowania
6)
7
8; => nil
(some->> [2 4 6 8]      ; rezultat [2 4 6 8]
         (filter odd?)  ; rezultat (filter odd? [2 4 6 8]) => ()
         first          ; rezultat (first ()) => nil
         (+ 2)          ; brak wartościowania
         println        ; brak wartościowania
)

; => nil
W linii nr 2 użyliśmy nieomawianej jeszcze funkcji filter. Dokonuje ona filtrowania
kolekcji podanej jako drugi argument, a do decydowania o tym, czy element zostanie
wpisany do wyjściowej struktury danych, czy pominięty, używa predykatu przekazanego
jako pierwszy argument wywołania.
Tu rolę predykatu pełni funkcja odd?, która zwraca logiczną prawdę, gdy wartość
przekazanego jej argumentu jest liczbą nieparzystą. W efekcie filter wygeneruje
pustą kolekcję, ponieważ wejściowa zawiera same liczby parzyste.
Wywołanie first w odniesieniu do pustej kolekcji zwróci nil i na tym przewlekanie
się zakończy. Gdybyśmy nie zastosowali makra some->>, wtedy S-wyrażenie (+ 2 nil)
doprowadziłoby do zgłoszenia wyjątku podczas wartościowania.
Przewlekanie warunkowe, cond->
Makro cond-> działa podobnie do ->, jednak S-wyrażenia interpretowane są
parami. Pierwsze z każdej pary jest wyrażeniem warunkowym, a drugie będzie
wartościowane wtedy, gdy pierwsze jest prawdziwe (jego wartością nie jest false ani
nil). Każde drugie wyrażenie par traktowane jest jak forma wywołania, nawet jeżeli
nie ujęto go w nawiasy.
Warunkowe przewlekanie pierwszego argumentu przydaje się do czytelnego wyrażenia zestawu obliczeń, które zależą od aktualnych warunków.
Użycie:
(cond-> wyrażenie & para…),
gdzie para to:
predykat wyrażenie.
Makro cond-> przyjmuje wyrażenie początkowe oraz pary S-wyrażeń, gdzie pierwsze
jest predykatem, a drugie będzie wartościowane w taki sposób, że jako pierwszy
argument będzie wstawiony rezultat wartościowania poprzedniego wyrażenia
z łańcucha. Wartością zwracaną jest wartość ostatnio obliczonego S-wyrażenia.
cond->
 1(def dodaj-jeden?    true)
 2(def odejmij-jeden? false)
 3
 4(cond-> 123      ; rezultat 123
 5         dodaj-jeden?   inc  ; rezultat (inc 123) => 124
 6         odejmij-jeden? dec  ; brak wartościowania
 7         true       println  ; rezultat (println 124) => nil
 8)
 9
10; => nil
11; >> 124
(def dodaj-jeden?    true)
(def odejmij-jeden? false)

(cond-> 123      ; rezultat 123
         dodaj-jeden?   inc  ; rezultat (inc 123) => 124
         odejmij-jeden? dec  ; brak wartościowania
         true       println  ; rezultat (println 124) => nil
)

; => nil
; >> 124
Przewlekanie warunkowe, cond->>
Makro warunkowego przewlekania ostatniego argumentu działa podobnie do cond->, ale
– jak wskazuje nazwa – dochodzi do podstawiania wartości ostatnio przeliczanego
S-wyrażenia w miejsce ostatniego argumentu wyrażenia aktualnie przeliczanego.
Warunkowe przewlekanie ostatniego argumentu przydaje się do czytelnego wyrażenia transformacji dokonywanych na kolekcjach, ponieważ wiele wbudowanych funkcji operujących na tego typu strukturach danych przyjmuje je jako ostatnie argumenty.
Użycie:
(cond->> wyrażenie & para…),
gdzie para to:
predykat wyrażenie.
Makro cond->> przyjmuje wyrażenie początkowe oraz pary S-wyrażeń, gdzie pierwsze
jest predykatem, a drugie będzie wartościowane w taki sposób, że jako pierwszy
argument będzie wstawiony rezultat wartościowania poprzedniego wyrażenia
z łańcucha. Wartością zwracaną jest wartość ostatnio obliczonego S-wyrażenia.
cond->
 1(def parzyste?     true)
 2(def nieparzyste? false)
 3
 4(cond->> [1 2 3 4]                   ; [1 2 3 4]
 5         parzyste?    (filter even?) ; (filter even? [1 2 3 4]) => (2 4)
 6         nieparzyste? (filter odd?)  ; brak wartościowania
 7         true         println        ; (println '(2 4)) => nil
 8)
 9
10; => nil
11; >> (2 4)
(def parzyste?     true)
(def nieparzyste? false)

(cond->> [1 2 3 4]                   ; [1 2 3 4]
         parzyste?    (filter even?) ; (filter even? [1 2 3 4]) => (2 4)
         nieparzyste? (filter odd?)  ; brak wartościowania
         true         println        ; (println '(2 4)) => nil
)

; => nil
; >> (2 4)
Wiązanie z nazwą, as->
Makro as-> służy do przewlekania rezultatów wyrażeń, ale zamiast ustalonej pozycji
mamy do czynienia z wytwarzaniem powiązań z symboliczną nazwą. Przydaje się to
w sytuacjach, gdy różne wywołania wymagają umieszczenia istotnego argumentu w różnych
miejscach.
Użycie:
(as-> wyrażenie symboliczna-nazwa & wyrażenie…).
Argumentami makra jest wyrażenie początkowe, którego wartość będzie powiązana z symboliczną nazwą (podaną jako drugi argument), a następnie przewlekana przez podane dalej S-wyrażenia w taki sposób, że wartość każdego z nich będzie powiązana z symboliczną nazwą przed wywołaniem kolejnego.
as->
1(as-> [1 2 3 4] wynik       ; po podstawieniu wyniku:
2      (filter even? wynik)  ; (filter even? [1 2 3 4])
3      (last wynik)          ; (last [2 4])
4      [wynik (inc wynik)])  ; [4 5]
5
6; => [4 5]
(as-> [1 2 3 4] wynik       ; po podstawieniu wyniku:
      (filter even? wynik)  ; (filter even? [1 2 3 4])
      (last wynik)          ; (last [2 4])
      [wynik (inc wynik)])  ; [4 5]

; => [4 5]
Podsumowanie
Tłumaczenie kodu źródłowego
Poniższy diagram przedstawia poszczególne etapy tłumaczenia kodu źródłowego programu z postaci tekstowej na wykonywalną, włączając proces uruchamiania i uzyskiwania wartości wyrażeń.
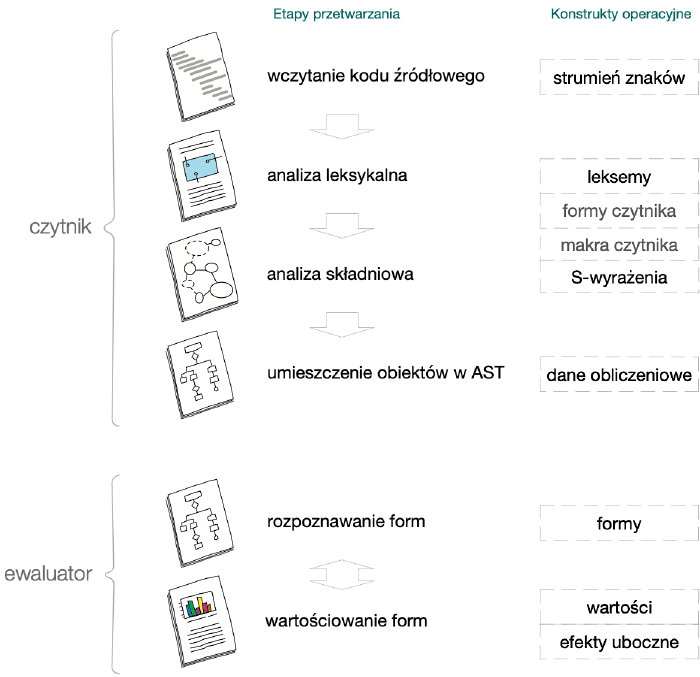
Pytania i odpowiedzi
Odpowiedzmy sobie na kilka pytań, które pozwolą podsumować wprowadzenie do podstawowych mechanizmów obecnych w Lispach (i w Clojure):
-
Jaka jest różnica między S-wyrażeniem a listą?
S-wyrażenie jest tekstowym zapisem danych symbolicznych. Lista to sekwencyjna struktura danych w pamięci. Odczytanie S-wyrażenia ujętego w nawiasy zwykle wytwarza listę, która może być później wartościowana jako forma albo przetwarzana jak zwykłe dane.
-
Jaka jest różnica między S-wyrażeniem a atomem?
W tradycyjnej terminologii Lispu atom jest niezłożonym S-wyrażeniem. Nie należy go mylić z typem referencyjnym
Atomw Clojure. -
Jaka jest różnica między S-wyrażeniem a formą?
Forma jest wartością Clojure przedstawioną do wartościowania. Mogła powstać z S-wyrażenia odczytanego z tekstu albo zostać skonstruowana bezpośrednio jako dane.
-
Jaka jest różnica między symbolem a zmienną globalną?
Obiekt przestrzeni nazw odwzorowuje symbol na
Var. Var udostępnia powiązanie główne, a gdy dozwolone jest dynamiczne przepowiązanie — ewentualnie bieżące powiązanie wątku. Symbol nazywa Var, ale sam nie przechowuje odwołania do jego wartości.
Zobacz także: